 FreeRTOS
ESP32 / STM32 / Pico / Pico 2 ↗
Zephyr
ESP32 / STM32 / nRF52840 ↗
NuttX / ChibiOS
Pixhawk 4
PX4 + NuttX / ArduPilot + ChibiOS ↗
Linux / PREEMPT_RT
Raspberry Pi 5 / Jetson Orin / Intel / AMD ↗
本文内容
本文内容
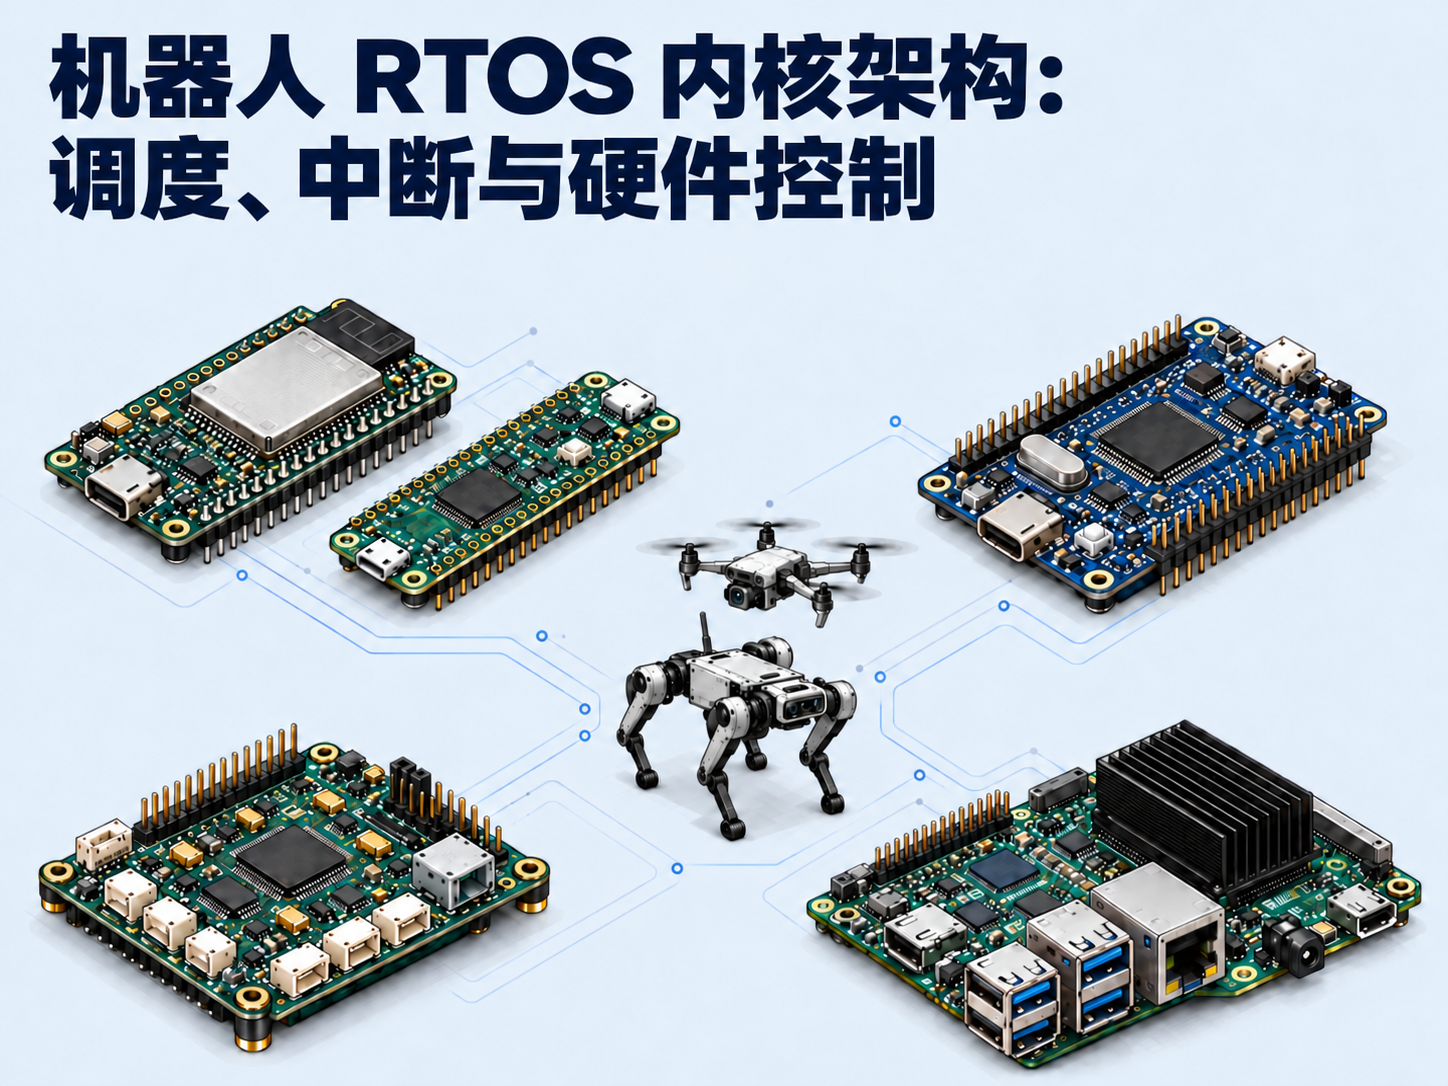
机器人需要正确的命令,而且命令必须在仍能发挥作用时到达。**实时操作系统(RTOS)**负责协调从传感到执行的工作。本文沿着一次关节修正,追踪传感器输入经过 RTOS 架构、最终成为硬件输出的全过程。
1. 处理器很快,机器人为什么仍然反应太迟?
四足机器人检测到不平整台阶,并算出正确的修正量
一台四足机器人踏上破损的铺路石。编码器报告关节角度发生变化,惯性测量单元(IMU)检测到机身旋转。控制器算出了修正量,但命令传向关节时,机器人仍在继续运动。
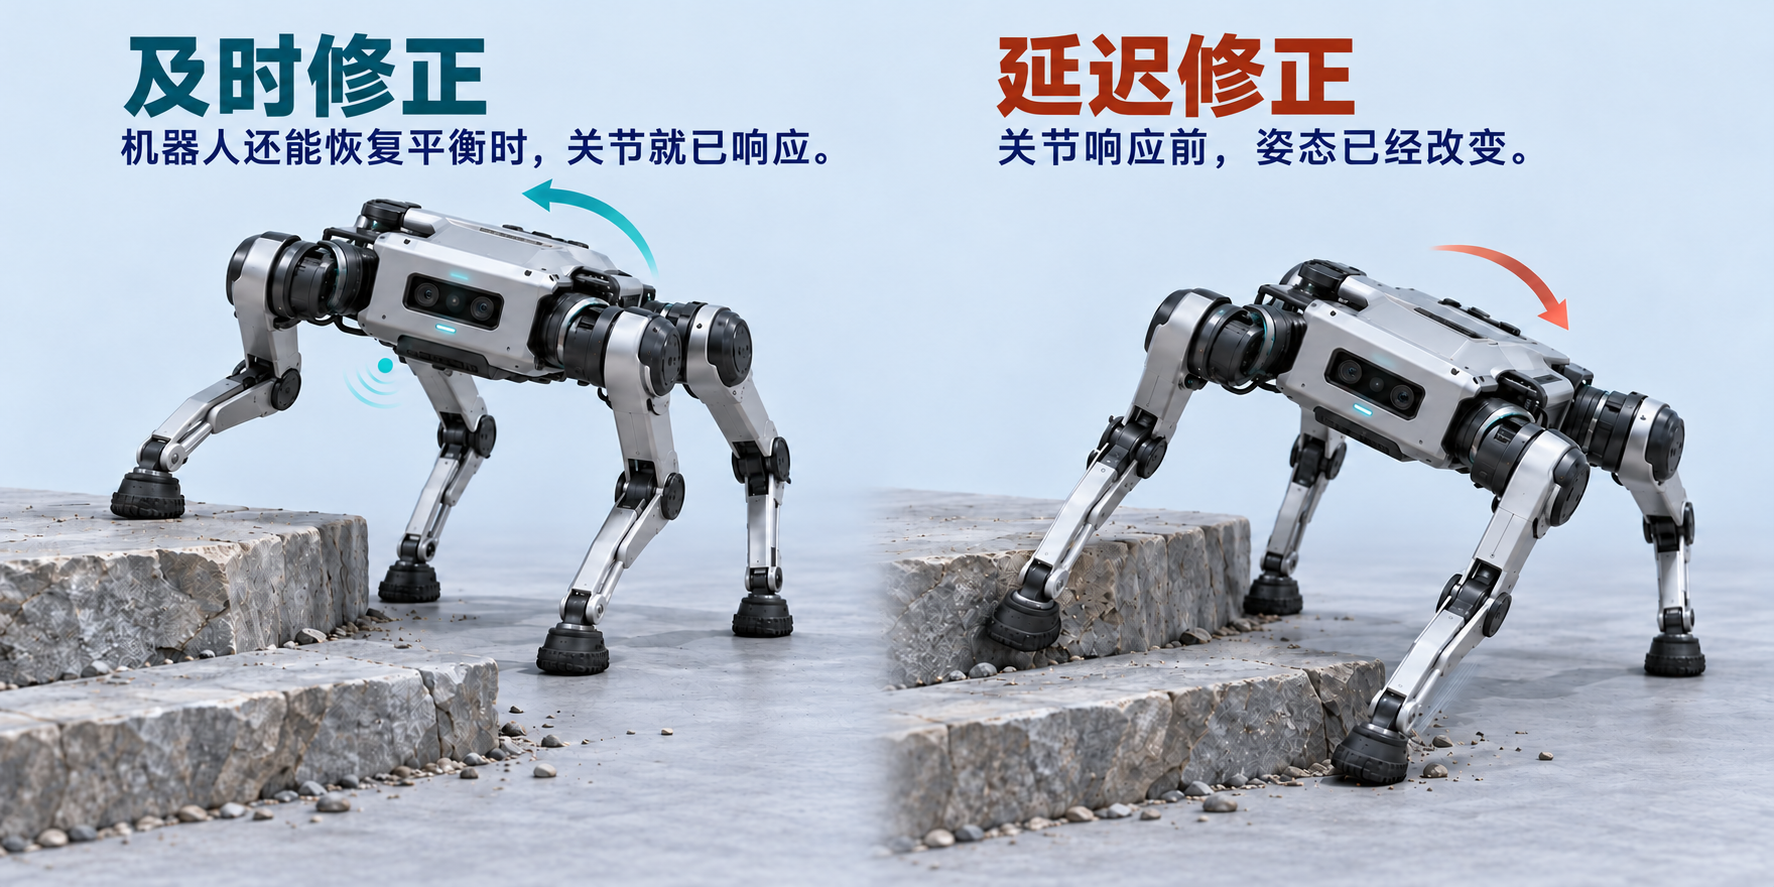
算对只是工作的一部分。基于先前姿态生成的命令,可能在姿态已经改变后才到达。
修正命令到达关节时,已经错过了需要它的时刻
假设本例要求执行器命令在传感器采样后的 1 ms 内生效。用 0.2 ms 算出答案,并不能证明整个响应过程都在时限之内。
- 周期
- 计划更新之间的时间间隔
- 截止时间
- 允许完成的最晚时刻
- 响应时间
- 从采样到命令应用
- 抖动
- 不同更新之间的时间波动
很短的平均响应时间可能掩盖偶尔发生的更新延迟。实时控制要求整条路径的耗时有足够严格的上限,并保持稳定。ROS 2 实时背景说明 详细解释了这一差别。
2. 控制器如何协调每一步
CPU、内存和驱动如何将传感器读数变成关节命令
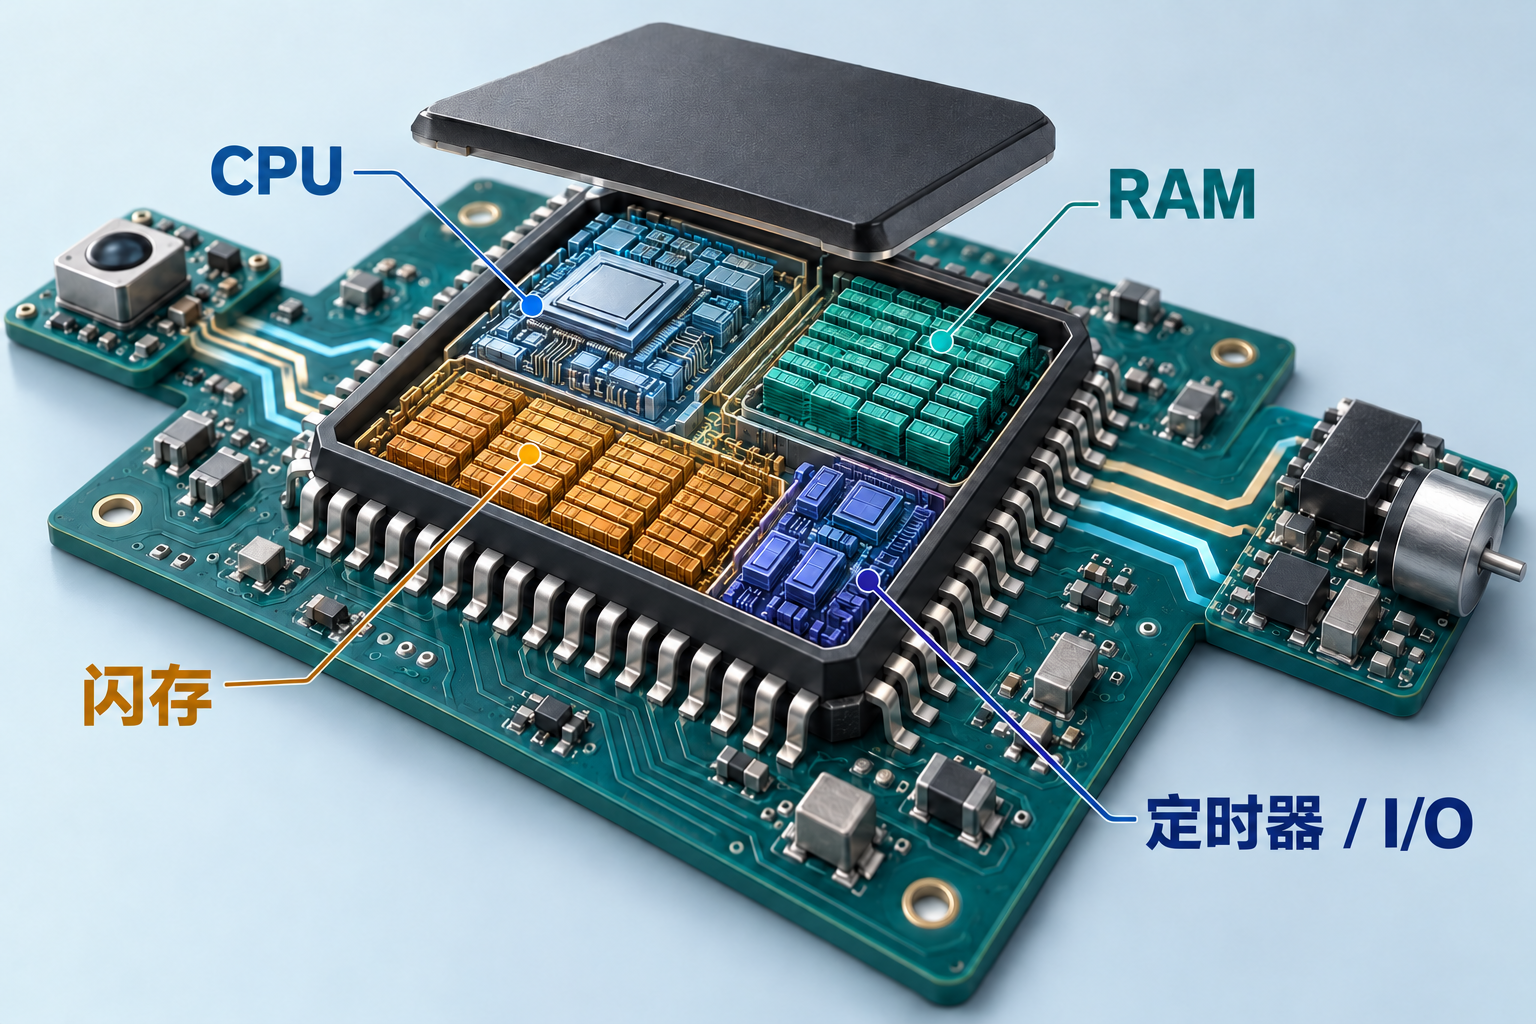
在基于微控制器的嵌入式系统中,CPU 读取测量值、计算目标值,再调用驱动。驱动配置外设,外设则将信号传到执行器接口。
机器人硬件指南 介绍了电机、传动机构、传感器和关节负载如何共同决定执行器接口。
- 传感器IMU/编码器获取采样数据
- CPU + RAM控制任务计算目标值
- 驱动程序寄存器写入配置传输
- 外设定时器/CAN传递信号
- 关节驱动器功率级应用命令
PWM 驱动可以写入定时器的比较寄存器,随后由定时器生成脉冲,无需 CPU 逐个翻转信号边沿。总线驱动则负责准备传输,有时会借助 DMA。写入寄存器、完成传输、应用命令,是三个不同的时刻。
从指令层面看,内存映射寄存器是由外设总线解码的地址。CPU 的存储指令改变的是硬件状态,而非普通 RAM 变量。定时器可能只在下一次更新边界才锁存新的比较值;ST 定时器应用指南 解释了这种预加载机制。CAN 传输也必须等待总线访问权,然后由驱动器决定何时应用命令。这些等待并不由任务选择本身解决。
- 01CPU存储指令
- 02定时器比较寄存器
- 03PWM波形
- 04电机驱动器
控制引脚传递信号,电机驱动器提供工作功率,也可能自行运行更快的电流环。支撑物理 AI 的电子系统 介绍了外围电路与供电路径。
xTaskCreate()配置的分配器从堆中提供 栈和TCB 。
xTaskCreateStatic()应用提供 栈数组和TCB存储空间。
- 栈
- 局部变量、函数调用和保存的CPU上下文
- TCB:任务控制块
- 优先级、链表链接和指向已保存栈上下文的指针
每个任务都需要 RAM 来容纳执行栈和 TCB。栈保存函数调用状态和已保存的寄存器;TCB 告诉内核这些上下文存放在哪里。即使任务处于阻塞(Blocked)状态,其栈空间仍被保留。
xTaskCreate()xTaskCreateStatic()在上游 FreeRTOS 中,xTaskCreate() 通过配置的分配器获取栈和 TCB;xTaskCreateStatic() 则接收应用提供的存储空间。两者都消耗 RAM,静态创建只是免去了这些对象的堆分配。上游 FreeRTOS 用 StackType_t 元素个数表示栈深度,而 ESP-IDF 的任务创建 API 使用字节。照搬栈大小前,应核对任务 API
和 IDF 移植端口的差异
。
内存预算有助于理解平台分工。小型 FreeRTOS 内核与 Linux 系统承载的服务不同。用数据选芯片之前,先比较每项数据究竟包含什么。
| 统计范围 | FreeRTOS 参考数据 | 嵌入式 Linux 参考数据 |
|---|---|---|
| 内核代码 / 存储空间 | 约 9–18 KBRichard Barry 在 2022 年给出的可用内核配置数据。FreeRTOS 体积讨论 ↗ | 约 2–4 MBBootlin 在 2017 年演讲中给出的嵌入式内核存储空间参考。Bootlin 内核体积参考 ↗ |
| 公开示例中的 RAM 用量 | 21,944 字节 约 22 KB一个 STM32F3 Crane 应用的示例,包含栈、缓冲区、对象和应用数据。2026 年研究 · 表 11 ↗ | 32 MB 或更多2022 年针对较为实用的小型 Linux 系统给出的参考;极简系统可能使用更少内存。Bootlin RAM 参考指南 ↗ |
内存选择:MCU 固件、Linux 与分配方式
在 MCU 嵌入式系统中,片上 SRAM 存放任务栈、采样数据和缓冲区,固件通常存放在闪存中。带外部 DRAM 和 MMU 的应用处理器可以支持 Linux 进程、虚拟内存和更庞大的驱动体系。无论哪种平台,单凭内存容量都无法保证时序。
应在循环开始前准备好关键工作内存。FreeRTOS 支持静态或动态对象分配 ,但栈、队列和缓冲区的大小仍需开发者确定。堆管理指南 说明了不同的内存管理方案。
RTOS 内核内部:任务、中断与调度如何协同
RTOS 是一种操作系统类别。 FreeRTOS 和 Zephyr 是提供调度与同步机制的具体实现。开发者配置这些机制,并实现自己的应用任务。
为说明 FreeRTOS 任务调度,本文采用抢占式单核配置。控制任务等待新数据时,传感与遥测各自拥有执行上下文。
内核在**任务控制块(TCB)**中保存任务状态。pxTopOfStack 指向已保存的上下文,uxPriority 决定优先级,链表项将任务连接到状态链表和事件链表。RTOS 上下文切换会从保存的执行位置恢复任务。
优先级 3 + 就绪 / 等待链表链接
保存的 CPU 上下文
允许切换时,调度器选择符合条件且优先级最高的就绪(Ready)任务。如果高优先级任务从不阻塞,就可能让低优先级工作一直得不到执行。可参阅 FreeRTOS 任务实现 。
在单核模型中,就绪链表按优先级索引。任务因等待队列而阻塞时,会从就绪集合移除并登记为等待者;设置有限超时还需要管理延时链表。事件或超时发生后,它才重新具备运行资格。内核会保护这些链表更新,防止中断看到只修改了一半的调度结构。某些配置使用针对移植端口优化的位图查找优先级,但并非所有芯片都使用同一种算法。
现在让传感器触发数据就绪中断。下图展示完整交接过程:就绪(Ready)还不等于运行(Running)。
- 1等待
- 控制
- 阻塞
- CPU
- 遥测任务
控制任务等待新采样数据,此时低优先级的遥测任务可以使用 CPU。
- 2中断
- 控制
- 阻塞
- CPU
- 传感器 ISR
数据就绪中断抢占任务执行,ISR 确认并处理传感器事件。
- 3唤醒
- 控制
- 就绪
- CPU
- 传感器 ISR
可在 ISR 中安全调用的内核操作唤醒控制任务。任务已可运行,但 ISR 仍在执行。
- 4切换
- 控制
- 就绪
- CPU
- PendSV / 上下文切换
当高优先级异常允许切换时,移植端口保存原任务的上下文,并恢复所选任务。
- 5运行
- 控制
- 运行
- CPU
- 控制任务
异常返回后恢复控制任务,它便可读取采样数据并计算关节修正量。
在 Cortex-M4F 移植端口上,切换请求可以将低优先级异常 PendSV 置为挂起。硬件先保存异常帧,然后由移植端口保存剩余任务上下文、选择另一个 TCB,并恢复该任务。进程栈指针(PSP)指向任务栈,处理程序代码则使用主栈指针(MSP)。
R0–R3 · R12 · LR · PC · xPSRR4–R11 · EXC_RETURN- 保存PendSV 将其余寄存器保存到切出任务的栈中。
- 选择
vTaskSwitchContext()在内核保护下选择下一个可运行任务。 - 恢复加载下一个 TCB 的栈指针,恢复移植端口保存的寄存器。
- 返回异常返回时恢复硬件帧,从保存的 PC 位置继续执行。
- PSP
- 任务栈指针
- MSP
- 处理程序栈指针
- BASEPRI
- 中断优先级屏蔽阈值
选择下一个任务时,移植端口会提高 BASEPRI,屏蔽那些可能访问内核数据的中断优先级。更紧急的中断可以保持启用,但不得调用相关 FreeRTOS API。PendSV 处于挂起状态,并不意味着它能强行打断正在运行的更高优先级处理程序来切换任务。这里专指 Cortex-M4F 移植端口
,并非 ESP32 的 Xtensa 或 RISC-V 汇编实现。
抢占可以在两个节拍之间响应事件。时间片轮转则在节拍到来时,让同优先级的就绪任务轮流运行。两者有独立的 FreeRTOS 配置开关 。
上下文切换内部:寄存器、栈与其他调度器
Cortex-M 异常会保存一部分 CPU 上下文。移植端口保存剩余任务上下文及其栈指针,异常返回时恢复所选任务的指令执行。Memfault 的讲解 涵盖 PSP/MSP、异常帧、BASEPRI 屏蔽和浮点上下文。
ISR 必须使用适当的 ISR 安全内核操作,并在 API 或移植端口要求时请求切换,无需等待下一个节拍。在适用的 Cortex-M 端口上,优先级高于 API 调用许可阈值的中断不得调用 FreeRTOS API。
FreeRTOS 任务管理示例 进一步介绍了单核模型。Zephyr 调度 则提供不同的就绪队列实现,以及协作式和抢占式线程类别。
队列、信号量与互斥锁如何协调任务和共享资源
这里的 RTOS 任务同步有两项工作:传递传感器采样数据,以及唤醒等待中的控制任务。应根据跨越任务边界的内容选择内核对象。
| 内核对象 | 承载内容 | 机器人中的用途 |
|---|---|---|
| 队列 | 数据缓冲的消息 | 带时间戳的传感器采样数据 |
| 二值信号量 | 0 或 1一个可用许可 | 传输完成信号 重复事件可能合并 |
| 计数信号量 | 0 … N多个许可 | 统计可用缓冲区槽位 |
| 互斥锁 | 所有权资源独占访问 | 保护任务级总线访问 基本优先级继承 |
采样数据可用后,等待接收的任务可以从阻塞(Blocked)转为就绪(Ready),随后才是获得 CPU 执行权。信号量传递的是可用状态,并不携带采样数据本身;互斥锁还包含所有权和基本优先级继承。
FreeRTOS 的队列由环形数据缓冲区、元素计数,以及等待发送或接收的任务链表组成。发送时会复制指定元素大小的字节,并可能唤醒一个等待中的接收任务。信号量使用大小为零的数据元素来复用队列机制:关键是计数和等待链表,而不是数据缓冲区。互斥锁还会跟踪持有者,以便内核暂时提高该任务的优先级。队列实现 具体展示了这些关系。
队列数据新鲜度、事件计数与所有权
二值信号量最多保留一个许可,因此重复事件可能合并。计数信号量跟踪多个可用许可。FreeRTOS 也提供任务通知;如果其语义符合事件需求,它很适合只有一个接收任务的场景。
需要决定控制队列满时,是拒绝新数据、覆盖旧数据,还是报告溢出。积压的旧数据可能不如最新的一份完整采样有用。使用指针传递消息时,还必须明确缓冲区所有权。可参阅队列示例 和队列/信号量共用实现 。
3. 为什么关键修正仍可能延迟
已就绪的控制任务为什么不能总是立即运行
高优先级任务可能已具备运行资格,却仍无法接管 CPU;也可能还在等待某项依赖。仅提高任务优先级,并不能自动消除这两类等待。
CPU 正在执行受保护操作或中断处理,任务必须等待调度。
所需采样数据、资源或超时条件尚未满足。
临界区、中断屏蔽、调度器挂起和 ISR 执行都可能推迟任务调度,FreeRTOS 也不例外。受保护操作并没有特殊的“最高任务优先级”,它只是暂时限制了可以切换任务的时机。
| 机制 | CPU 或内核的行为 | 控制任务在等什么 |
|---|---|---|
| 非 RT Linux 自旋锁 | spin_lock() 会禁止本地任务抢占;IRQ 可能仍保持启用。 | 受保护区间结束,随后允许重新调度。 |
| 中断屏蔽 | 被屏蔽的中断源暂时无法进入处理程序。 | 解除屏蔽、处理事件以及随后的调度执行。 |
| ISR 执行 | 处理程序上下文占用 CPU,不参与普通任务选择。 | 可以进行异常返回或上下文切换的时机。 |
| 调度器挂起 | vTaskSuspendAll() 会推迟任务切换,但本身不会屏蔽中断。 | 调度器恢复以及延后的管理处理。 |
| 互斥锁依赖 | 任务因等待另一任务持有的资源而阻塞。 | 持有者继续执行并释放资源;优先级继承可减少其他任务的干扰。 |
假设在未启用 PREEMPT_RT 的 Linux 上,某个驱动持有 spinlock_t。已启用的中断可以唤醒更高优先级的控制线程,并设置重新调度请求。但中断返回后,CPU 仍可能需要先完成驱动的受保护区间,才能切换。控制线程虽已就绪,剩余受保护操作仍必须计入其响应时间预算。
FreeRTOS 的 vTaskSuspendAll() 不等于屏蔽中断:ISR 仍可执行,但任务切换要等调度器恢复并处理延后的工作。Cortex-M 临界区则使用移植端口特有的中断屏蔽。提高任务优先级无法撤销这两种机制。Linux 锁规则
解释了相关自旋锁与 IRQ 的区别。
数值越大,优先级越高
- 中 · 2执行日志记录
- 低 · 1完成 + 解锁
- 高 · 3获取互斥锁 + 控制
- 低 · 1 → 3完成 + 解锁
- 高 · 3获取互斥锁 + 控制
- 中 · 2稍后执行日志记录
对于支持优先级继承的互斥锁,持有者会暂时继承等待它的高优先级任务的优先级,使其更容易完成工作并释放资源。它不会消除临界操作、解决死锁,也不能为永不响应的设备设定有效等待上限。
内核保护、中断优先级与多核锁
在非 PREEMPT_RT 的 Linux 配置中,获取普通自旋锁会禁止该 CPU 上的任务抢占。禁用 IRQ 的变体还会增加本地中断屏蔽。Linux 锁规则 区分了这些机制。
任务优先级与硬件中断优先级是两回事。移植端口的屏蔽阈值决定哪些中断可以调用内核。在多核系统中,仅有本地保护未必能保护其他 CPU 也可访问的资源。
应限制资源持有时间,并分析锁链。FreeRTOS 资源管理章节 说明了互斥锁所有权与基本优先级继承。
FreeRTOS 与桌面 Linux 有何不同,PREEMPT_RT 又改变了什么
比较 RTOS 与 Linux 时,必须考察完整响应路径。两种内核都会管理任务状态、优先级、抢占和中断,区别在于配置后的系统如何控制整条路径中的干扰。
- TCB + 按优先级组织的就绪链表
- 选择符合条件的最高优先级任务
- ISR 安全 API 唤醒任务
- 仍存在的延迟: 临界区可能推迟切换
SCHED_FIFO / SCHED_RR可用- 硬中断处理可能推迟调度
spinlock_t禁止本地任务抢占- 仍存在的延迟: 受保护路径会推迟切换
- 大部分 IRQ 工作在线程中执行
spinlock_t使用基于 RT 互斥锁的优先级继承- 更多内核路径变得可抢占
- 仍存在的延迟: raw 锁和底层路径仍受保护
PREEMPT_RT 是 Linux 的一种配置,不是 FreeRTOS 功能。 它通过线程化中断和支持优先级继承的可睡眠锁,将更多内核工作纳入调度器控制。
典型的线程化 IRQ 路径保留一小段硬中断入口处理,用于确认或屏蔽中断源,再唤醒 IRQ 线程。该线程依据调度策略和优先级竞争执行。PREEMPT_RT 将普通 spinlock_t 改为基于 RT 互斥锁的实现:竞争者可以睡眠,优先级继承帮助持有者继续执行。raw_spinlock_t、底层入口路径和其他显式保护区间仍不可抢占。详见 RT 内核的差异
。
刻度:0–1,500 µs · 虚线:1,000 µs 截止时间
在合理配置的 PC 上,实时 Linux 可以承担机器人控制。不能直接假定普通 Ubuntu 满足严格时限,也不能对未经验证的 FreeRTOS 系统作出同样假定。开源许可证与这一时序问题无关。
即使调度已允许执行,内存仍可能带来额外延迟。使用虚拟内存时,指令可能因页面需要分配、写时复制或文件/交换区读取而触发缺页异常,只有其中一部分涉及存储设备。典型 MCU FreeRTOS 系统使用常驻内存而不采用按需分页,但分配、闪存/缓存访问、总线和设备仍可能导致停顿。
- 已预留 RAM
- 复用任务栈与缓冲区
- 没有按需分页引起的缺页步骤
Linux 控制线程应在循环开始前准备关键缓冲区和栈页,对所需映射预先触页,并在检查错误和限制的前提下使用适当的内存锁定。mlockall() 不会让未来的分配或写时复制变得毫无影响。PREEMPT_RT 本身也不会消除缺页异常;内存锁定手册
解释了这些限制。
Linux 优先级、缺页异常与 PREEMPT_RT 的权衡
Linux 提供普通应用调度策略,也提供 SCHED_FIFO、SCHED_RR 等实时策略。nice 值不能代替这些策略的配置。调度手册 定义了相关接口。
地址变为可用之前,缺页异常可能先引入额外工作。应预分配关键内存、预先触页,并在检查失败和限制的前提下使用适当的内存锁定。mlockall() 有助于保持内存驻留,但不能解决 CPU、锁、缓存或设备延迟。
线程化工作和不同的锁机制,可能在某些负载下增加开销或降低吞吐量。优先级、中断分配、电源管理、CPU 分配和驱动都需谨慎处理。成本取决于工作负载,不是固定百分比。可参阅 RT 理论 、内核差异 和硬件限制 。
现在给整个修正过程分配统一的时间预算,分别为传感、干扰、计算、传输和输出生效设定上限,并计入打断计算的高优先级工作。
固定阶段 480 µs + 等待 120 µs = 总计 600 µs
在 1,000 µs 截止时间内 · 余量 400 µs
固定阶段 480 µs + 等待 800 µs = 总计 1,280 µs
超过 1,000 µs 截止时间 · 超时 280 µs
采样 + 等待/干扰 + 计算 + 传输 + 应用输出 ≤ 截止时间。固定阶段合计 480 µs。 两个示例只改变等待时间额度。
等待 120 µs 时,示例总耗时为 600 µs,距离 1,000 µs 截止时间还剩 400 µs。等待 800 µs 时,固定工作相同,但总耗时变为 1,280 µs,即超时 280 µs。这些是教学示例数值,不是板卡实测数据。
- 0 µs获取采样数据传感器时间戳
- 70 µs进入 ISRGPIO / 跟踪标记
- 190 µs控制开始任务标记
- 390 µs计算结束驱动调用边界
- 510 µs传输完成总线抓取
- 600 µs输出生效驱动器 / 输出标记
应测量实际输出生效的边界。单看调度延迟,无法知道驱动器何时应用命令;一次运行中观察到的最大延迟,也不能证明最坏情况上限。
在硬件上验证完整路径
为传感器采集、ISR 入口、任务开始、计算结束、传输完成和输出生效分别记录时间戳。GPIO 标记与逻辑分析仪可以辅助测量,但标记必须对应同一事件,并明确时钟域。还应对竞争的通信、存储和中断施加负载。
Canonical 的 cyclictest 指南 测量的是路径中与调度相关的部分。Linux 实时应用监视器 有助于在支持的内核上诊断缺页与等待模式。ROS 2 实时背景说明 、PREEMPT_RT 内部机制 和 Zephyr 互斥锁文档 提供了更深入的解释。
4. 从本地控制到完整机器人
构建控制固件,并通过自定义 SDK 对外开放
选择 FreeRTOS 还是 Linux,应从负责感知和动作的硬件出发。RAM、CPU 架构、外设驱动和时序要求共同决定哪些软件能够承担工作。下面针对受支持的目标平台,各列出两种选择示例。
| 芯片 / 开发板 | 两种软件选择 | 适用原因 | 机器人角色与硬件依据 |
|---|---|---|---|
| ESP32 / S3 / C3无线 MCU 片上 SRAM 为数百 KB,容量因芯片而异。 | 精简的任务内核为 栈与无线缓冲区留出空间。IDF 集成芯片驱动和服务。 | 无线传感 / 机器人 I/O。 无线模块交换数据,定时器与 GPIO 处理本地信号。 | |
| RP2040 / RP2350Pico / Pico 2 MCU 264 KB / 520 KB SRAM ↗ | 裸机代码避免了内核任务开销;FreeRTOS 在 SRAM 内提供 调度与同步 功能。 | 编码器 / 脉冲生成。 PIO、定时器和 DMA 可采集或生成信号,无需 CPU 处理每个边沿。 | |
| STM32 F4 / F7 / H7Cortex-M MCU 系列 闪存与 SRAM 容量因型号而异。 | 可配置的 MCU 内核无需完整的 Linux 进程环境,即可组织 控制、传感与通信 任务。 | 电机 / 关节控制器。 ADC、定时器、DMA 和总线将反馈采样与执行器命令连接起来。 | |
| Nordic nRF52840无线 Cortex-M4 MCU 256 KB RAM · 1 MB 闪存 ↗ | Zephyr 集成无线服务;独立驱动适用于 更简单的外设固件。两者都需要规划 RAM 用量。 | 电池供电传感器。 无线和休眠模式适合间歇采样;裸机 nrfx 本身并不是 Bluetooth 协议栈。 | |
| STM32F765Pixhawk 4 飞控 512 KB RAM · 2 MB 闪存 ↗ | 针对特定板卡的飞行固件将 RTOS 与 传感器驱动、任务栈和缓冲区结合使用。 | 无人机姿态稳定。 IMU 采样、估计与控制共同生成及时的 ESC 命令。 | |
| BCM2712Raspberry Pi 5 应用 SoC GB 级外部 DRAM ↗ | MMU 和外部 DRAM 支持 进程、虚拟内存、文件系统和 Linux 驱动。 | ROS 2 / 摄像头 / 网关。 多核计算和摄像头/网络 I/O 支撑主机并发工作负载。 | |
| NVIDIA OrinJetson CPU / GPU 模块 GB 级 DRAM,容量取决于模块。 | Linux 提供 GPU 和设备服务;在受支持的版本中,RT 内核会改变 CPU 调度与中断处理 机制。 | 视觉 / AI 推理。 GPU 处理图像帧和张量;CPU 实时调优并不能约束所有 GPU 操作的时限。 | |
| Intel / AMDPC 应用处理器 外部 DRAM + MMU。 | 广泛的进程和驱动平台承载大型应用;RT 配置减少 内核引起的等待。 | 开发 / 规划 / 经验证的控制。 CPU 能力支撑复杂工作负载;直接控制仍需合适的 I/O 和时序验证。 |
为传感和反馈控制设定明确的唤醒条件、优先级、执行时间上限,并提供足够的栈。不要让解析、网络通信、日志和存储工作长期占用关键循环所需的资源。
内核提供调度与同步,固件提供控制行为和驱动,自定义 SDK 则向外公开命令与实测状态。
前面的中断交接过程,可以写成下面这个简短的 FreeRTOS 模式。单元素队列保留最新的完整采样数据。应先创建队列和任务,再启用中断,并通过耗时有界的硬件路径获取采样。
void sample_isr(void) {
  BaseType_t wake = pdFALSE;
  Sample s = read_ready_sample();
  xQueueOverwriteFromISR(
    sample_q, &s, &wake);
  portYIELD_FROM_ISR(wake);
}
复制一个已完成的采样数据;高优先级任务被唤醒时请求切换。
void control_task(void *arg) {
  Sample s;
  for (;;) {
    xQueueReceive(sample_q, &s,
                  portMAX_DELAY);
    Target t = target_snapshot();
    Command u =
      control_step(s, t);
    actuator_write(u);
  }
}
采样间隔内阻塞等待,使用一致的目标值和耗时有界的输出路径。
ISR 复制一份已完成的采样数据,并在需要时请求切换。任务在等待期间不消耗 CPU,随后读取一致的目标快照、计算下一次输出,再调用驱动。包含多个字段的目标值,应通过消息传递或耗时有界的任务级锁,复制为一个一致版本;不要在慢速 I/O 期间一直持有这把锁。
对于周期循环,应使用合适的定时器或 xTaskDelayUntil(),避免反复使用相对延时而累积工作耗时。节拍分辨率必须匹配周期;小于一个节拍的时序要求,需要合适的硬件计时源。
在现有内核配置中设置 configUSE_PREEMPTION、优先级范围、分配选项和栈大小,再实现任务及其同步。通常应配置和移植调度器,而不是自行编写就绪链表选择逻辑。在支持的双核 ESP-IDF 配置中运行 ESP32 上的 FreeRTOS 时,调度器还会考虑核心亲和性。将任务固定到某个核心,并不能隔离共享内存或总线;本地中断屏蔽也不会停止另一个核心。共享数据需要使用目标平台支持的跨核同步机制。
- 关节
- joint_3
- position_rad
- 0.15
- sequence
- 42
- 有效期
- 定义的有效时间窗
- 实测位置
- 弧度
- 采样时间戳
- 声明的时钟域
- 已应用的序列号
- 使用了哪条命令
- 状态
- 新鲜 / 过期 / 故障
定义单位、接受范围、时间戳、序列号、确认响应、新鲜度和超时行为。收到命令,并不等于已经执行了物理动作。
在通信边界上,应明确序列化方式,包括字段宽度、字节序、帧格式及必要的完整性检查。不要直接发送 C 结构体,因为主机端的填充布局可能不同。控制器验证数据包、发布完整目标值,并报告实际应用的序列号。超时后可以选择适合机构的预定义保持、渐降或故障响应。SDK 应公开这个状态,而不是把接收成功包装成运动成功。
开发定制机器人时,应将这些接口与传感、执行器集成一同确定范围。VoicePing 的定制机器人开发 从任务及其运行环境出发。
ESP-IDF、上游 FreeRTOS 与多核选择
ESP-IDF 集成了自己的 FreeRTOS 实现、驱动和启动路径。受支持的多核目标还需考虑亲和性与共享资源。上游 FreeRTOS 也支持 SMP,因此不必手工实现全部多核调度。
应遵循对应目标与版本的 IDF 文档 。核心绑定可以减少部分竞争,但不能隔离共享总线、内存或中断的影响。定义时钟同步,并明确时间戳表示采集时刻还是发送时刻,再验证配置后的系统。
内核如何成为产品平台。 定制可以发生在内核移植端口、应用固件或外部 SDK 边界。企业无需重写调度器,也能做出自己的控制器。
FreeRTOS↓目标移植端口 + SMP 集成 + 硬件驱动↓应用任务 + 网络 / 外设服务开发者定制的内容任务优先级、亲和性、缓冲区、 同步和应用行为。
FreeRTOS 任务↓传感器就绪 → 估计器 → 控制器 → 电机输出↓设定值、参数、日志 + 板级支持开发者定制的内容控制算法与驱动、 平台配置和应用模块。
rt/lowcmd → 机器人qdqkpkdtau⇅rt/lowstate → 应用开发者定制的内容主机控制逻辑使用 电机目标值和实测状态。 SDK 并未说明关节控制器使用的 OS。
Espressif 公开说明了针对其硬件的 FreeRTOS 实现与集成方式。Bitcraze 的 Crazyflie 展示了另一条常见路线:使用 FreeRTOS 任务,再加入从传感器到估计器、控制器和电机的处理流水线。稳定控制文档 和固件源码 展示了这一应用层。
Unitree 则展示了公开接口层。SDK2 Go2 示例 发布低层电机命令并订阅状态,Python SDK 文档说明了 Cyclone DDS 的使用 。这证明了机器人接口可扩展,却不能证明内部未公开的关节控制器使用 FreeRTOS。应区分有文档依据的 SDK 行为与对内部固件的推测。
在四足机器人和无人机中,将本地 RTOS 控制连接到 ROS 2
现在把控制器放进整台机器人。主机可以规划运动,本地控制器闭合反馈环,关节驱动器调节电流。每个循环都应放在能够验证其时序的位置。
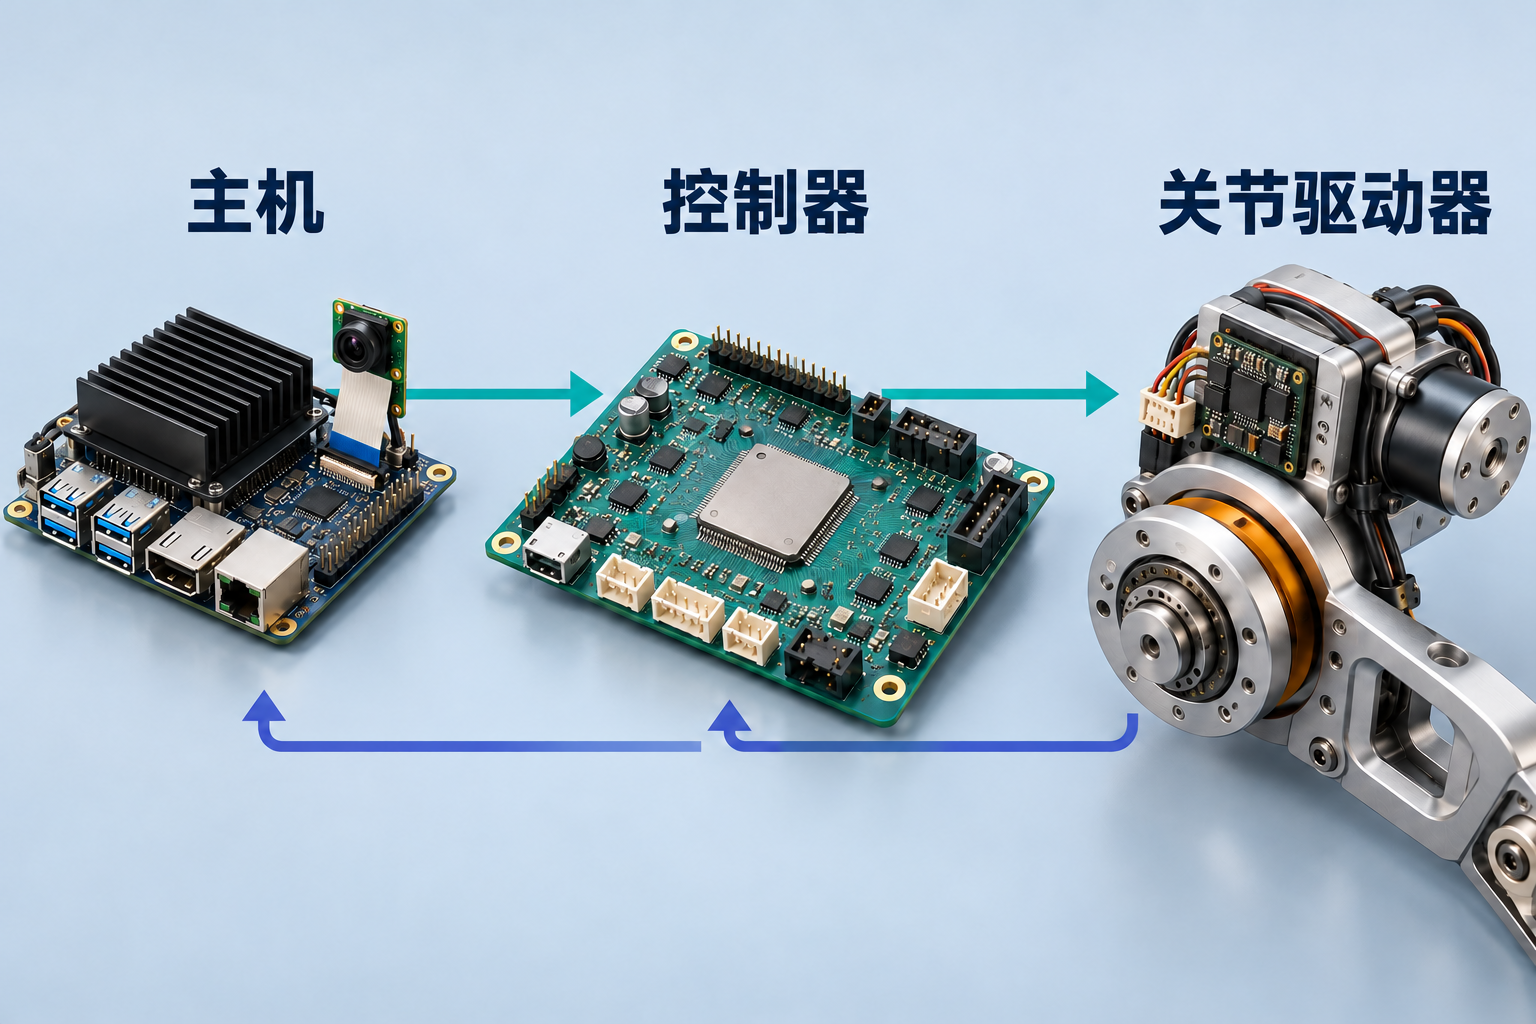
ROS 2 是中间件,RTOS 是操作系统内核或平台。 两者职责不同,经常配合使用。选定的循环也可以在合适的 Linux/PREEMPT_RT 主机上运行;ROS 2 实时设计讨论 说明了应用层的约束。
Linux 为主机提供进程、摄像头/网络驱动、机器人库和部署工具,因此很适合承担主机工作。PREEMPT_RT 保留这一平台,同时改善内核响应能力。ROS 2 回调仍需合适的执行器/线程策略、耗时有界的工作和预先准备的内存;RT 内核不会自动让每个回调具备实时性。FreeRTOS 则为本地固件提供更小的执行环境,并不能直接承载主机的整套 Linux 软件栈。
先确定时序要求,再选择内核。 视觉或建图主机可能更需要吞吐量和丰富的驱动支持,而由独立 MCU 闭合快速环路。如果 Linux 主机直接承担严格的控制时限,就需要适当的实时配置与端到端验证。PC 可以运行 PREEMPT_RT,但普通桌面工作负载往往不需要那么严格的延迟目标。
| 成本或要求 | 产生原因 | 应用决策 |
|---|---|---|
| 可能降低吞吐量 | IRQ 线程调度和优先级继承锁的管理会增加工作量。 | 测量真实工作负载;不存在通用的额外开销百分比。 |
| 更多配置工作 | 任务/IRQ 优先级、亲和性和共享资源相互影响。 | 在网络、存储和系统维护任务同时运行时验证控制。 |
| 低优先级任务饥饿风险 | 持续可运行的 RT 线程可能使低优先级工作无法执行。 | 约束执行和阻塞时间。未启用 PREEMPT_RT 时也存在此风险。 |
| 能耗权衡 | 某些延迟调优会限制深度空闲状态或频率变化。 | 平衡功耗与散热;仅启用 PREEMPT_RT 并不意味着必须进行这些调优。 |
| 驱动假设 | 普通自旋锁和中断执行上下文会发生变化。 | 检查那些假定自旋锁始终禁用抢占的自定义驱动。 |
这些成本取决于工作负载。IRQ 线程和优先级继承锁会增加管理工作,CPU 分配与驱动假设也需重新检查。禁用深度休眠或频率变化,可能以能效换取更短响应时间;这是调优选择,并非 PREEMPT_RT 自动产生的效果。Canonical 延迟指南 介绍了这些实际权衡。即便使用非 RT 内核,持续占用 CPU 的实时线程也可能让其他工作陷入饥饿。
这种共存也出现在开发者调查中。下面两个类别对应不同的硬件角色,既不是基准测试,也不是对某款 MCU 的推荐。
- Linux/Raspbian45%
- FreeRTOS32%
- 裸机21%
- Zephyr RTOS17%
- ThreadX17%
- ROS 27%
- Contiki / Contiki-NG5%
- Huawei LiteOS5%
- Linux/Raspbian62%
- Android23%
- Windows19%
- 裸机12%
- ThreadX10%
- Zephyr9%
理解“资源受限”时,应以应用可用的 RAM、闪存、CPU、功耗和 I/O 预算为参照。ESP32 级控制器与 Linux 边缘计算机可能面临不同限制。调查中广泛的 Linux 使用结果,并不能说明桌面 Linux 适合 ESP32。必须针对实际板卡核对内存容量、MMU 支持、驱动和实测循环时序。
- IMU测量运动
- 估计器估计姿态
- 控制器计算修正量
- ESC驱动电机各相
- 电机改变推力
同样的模式也支撑无人机姿态稳定。在受支持的飞控板上,PX4 通常使用 NuttX;ArduPilot 在许多 STM32 目标上使用 ChibiOS。可参阅 PX4 飞行栈概述 、系统架构 和 ArduPilot 移植指南 。
回到四足机器人
现在,我们可以追踪不平整台阶引发的修正,直到它到达关节。内核组织执行,而完整的传感、控制和执行路径决定了修正能否及时到达。
设计下一款控制器时,请把一个传感器事件一路追踪到物理输出。明确截止时间,计入每段等待,并在硬件上验证输出生效的边界。
要将控制器用于实际应用,可以了解 VoicePing 的机器人工程方法 ,共同定义硬件、控制接口和验收标准。