本文内容
VoicePing 的长期目标,是打造能够理解有用的任务、在物理世界中行动,并在情况变化时作出调整的机器人。如果每换一个房间、一条路线,或遇到一点变化,都要单独训练,部署规模就很难扩大。
机器狗项目为我们提供了一个研究平台,用来探索机械结构、感知和学习型控制如何支撑这一目标,以及它们在实机试验中会遇到哪些限制。
有用的机器人必须应对情况变化
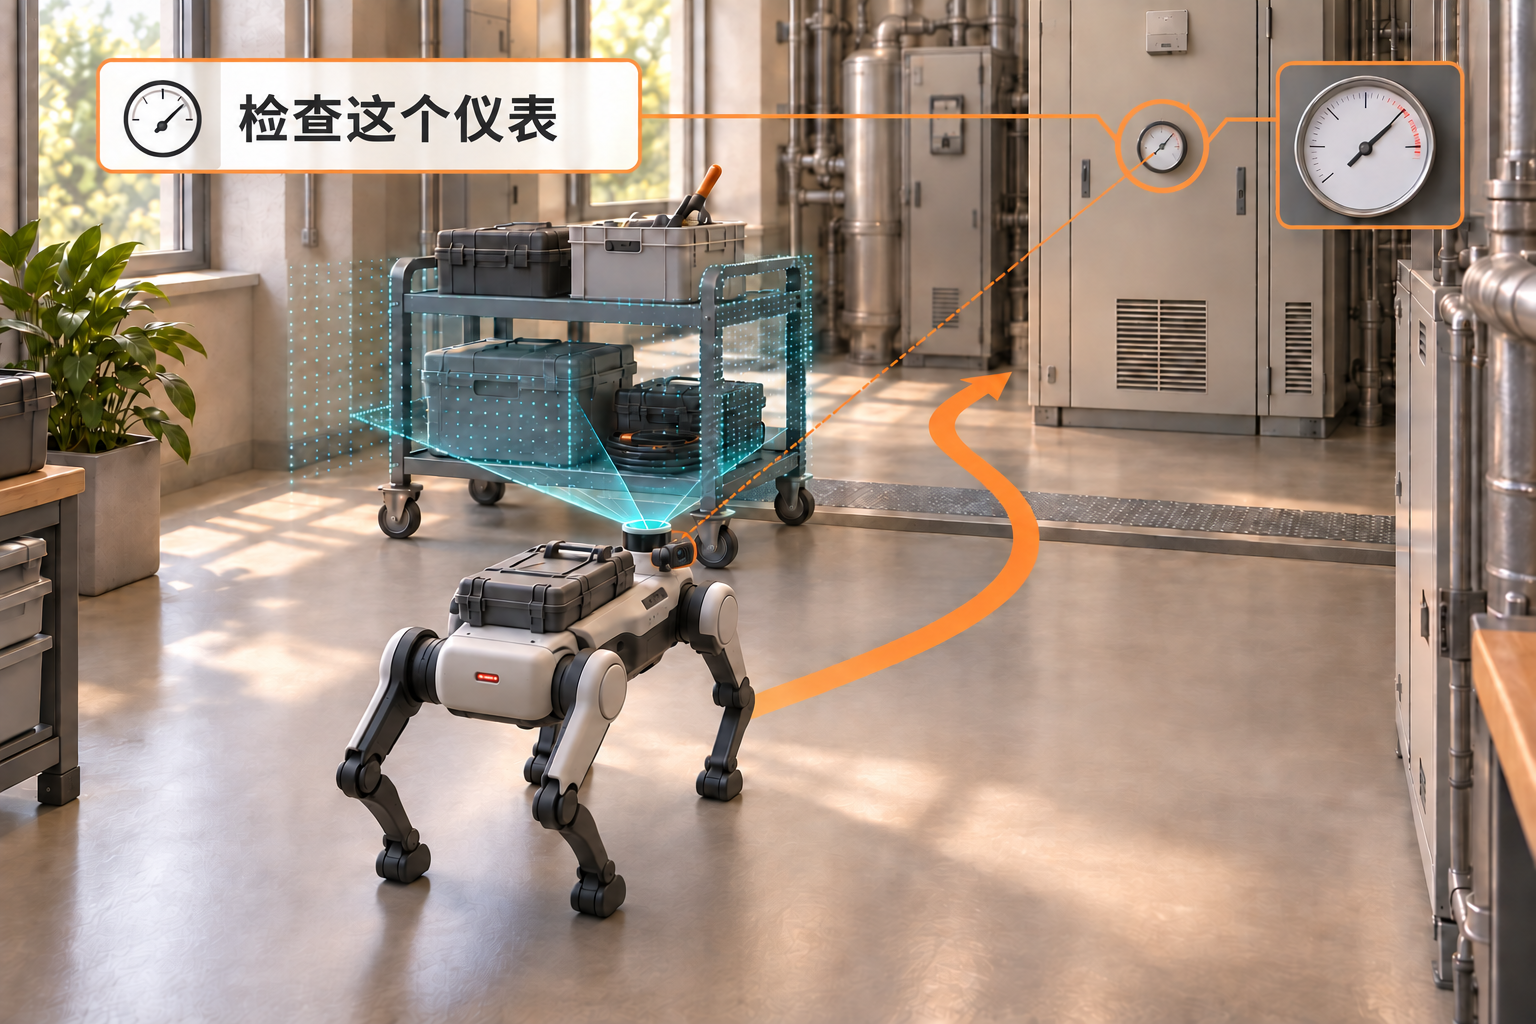
以室内巡检为例:机器人需要前往某台设备,观测其状态,并报告需要关注的问题。
推车挡住路线时,需要重新规划路径。如果巡检目标变了,则需要做更多判断:把指令与正确的物体对应起来,确定应该观测什么。到达目的地只是工作的一部分。
成功完成任务,意味着获得正确的观测结果,并识别何时需要人的帮助。
为什么机器狗适合作为研究平台
四足平台把平衡、不断变化的地面接触和运动中的传感器放在同一个实验中。执行器响应或机身运动估计中的微小误差,都可能影响每一步。
能够直接调整机械结构和控制系统,才能将这些误差与设计选择联系起来,并改进仿真器。我们想弄清楚,测量哪些物理量可以让学到的行为更可靠地迁移到实机。
最终用于客户场景的机器人,应当采用适合任务的机身形态。这个平台帮助我们建立作出这种选择所需的方法。
商用机器狗:Spot、ANYmal 和 Unitree
商用四足机器人让我们看到实际部署中值得关注的四个方面:
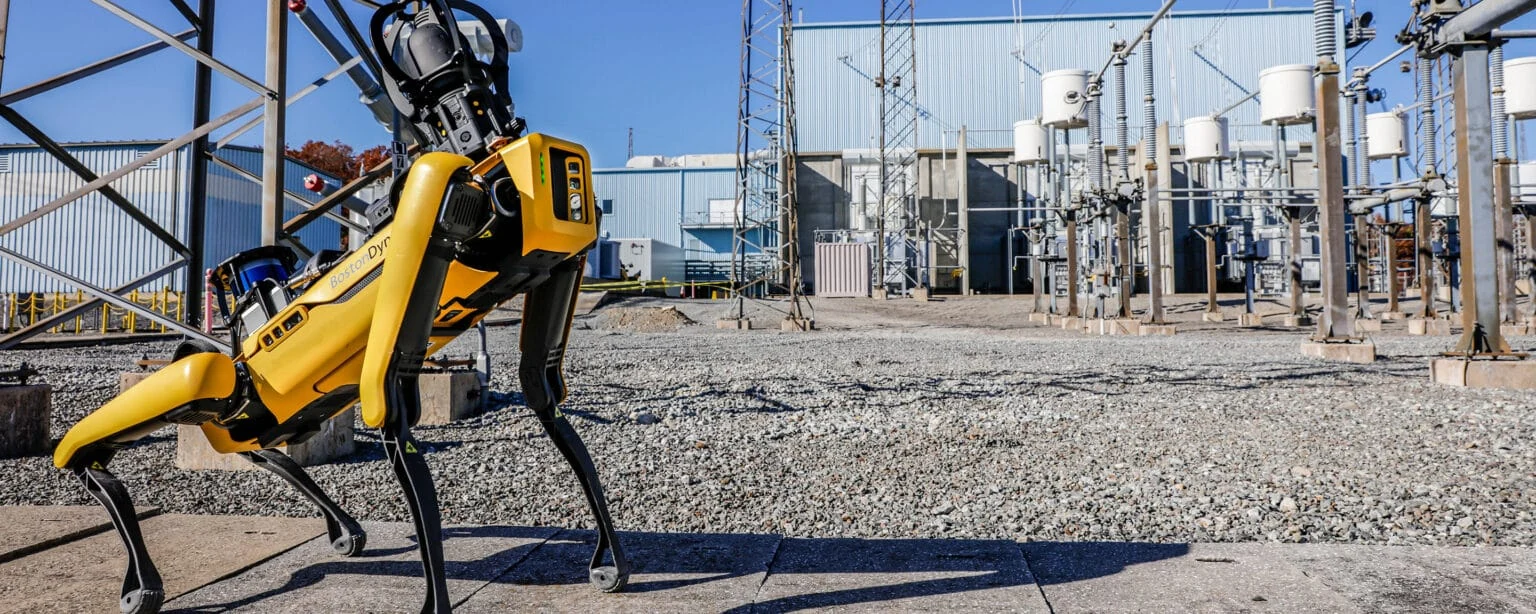
完成整个巡检流程
自主任务、可配置载荷,以及 Orbit 机器人集群管理。
研究视角: 评估观测结果是否有用,以及是否已准备好执行下一项任务。
图片:Boston Dynamics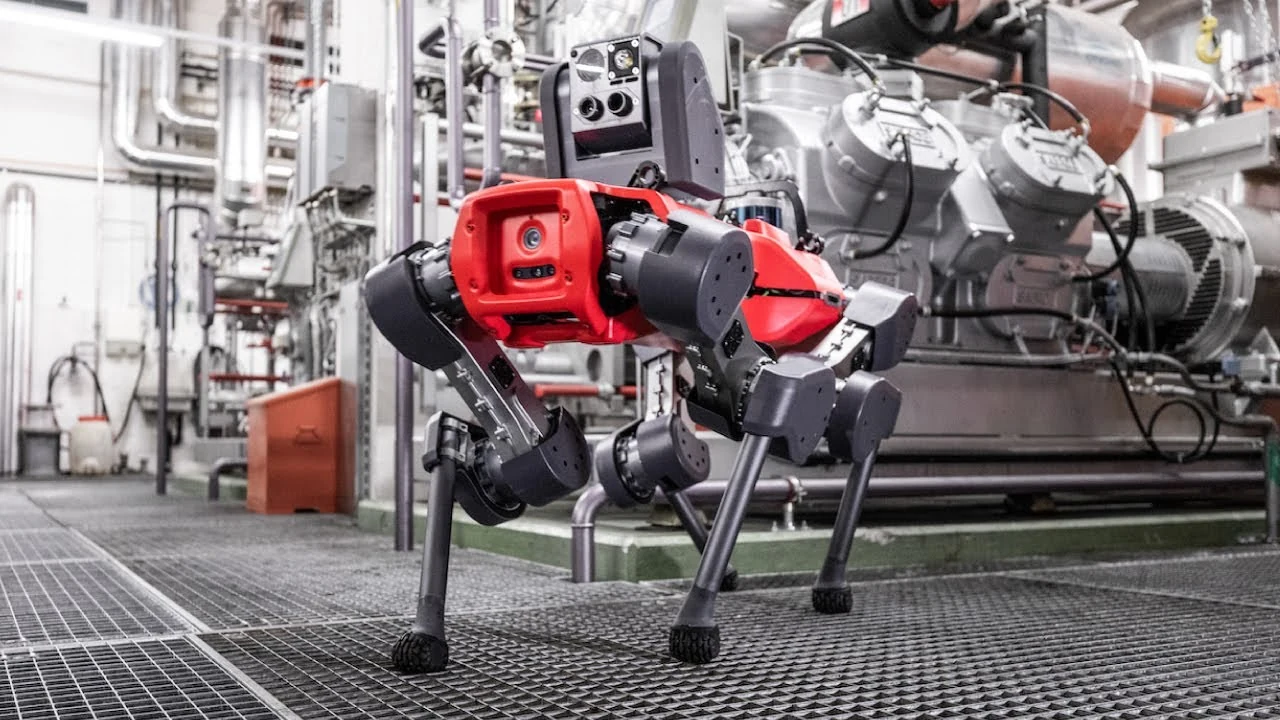
观测真正需要的状态
视觉、热成像和声学巡检,配合自主导航与对接。
研究视角: 让感知方式匹配任务,并检查重复观测的一致性。
图片:ANYbotics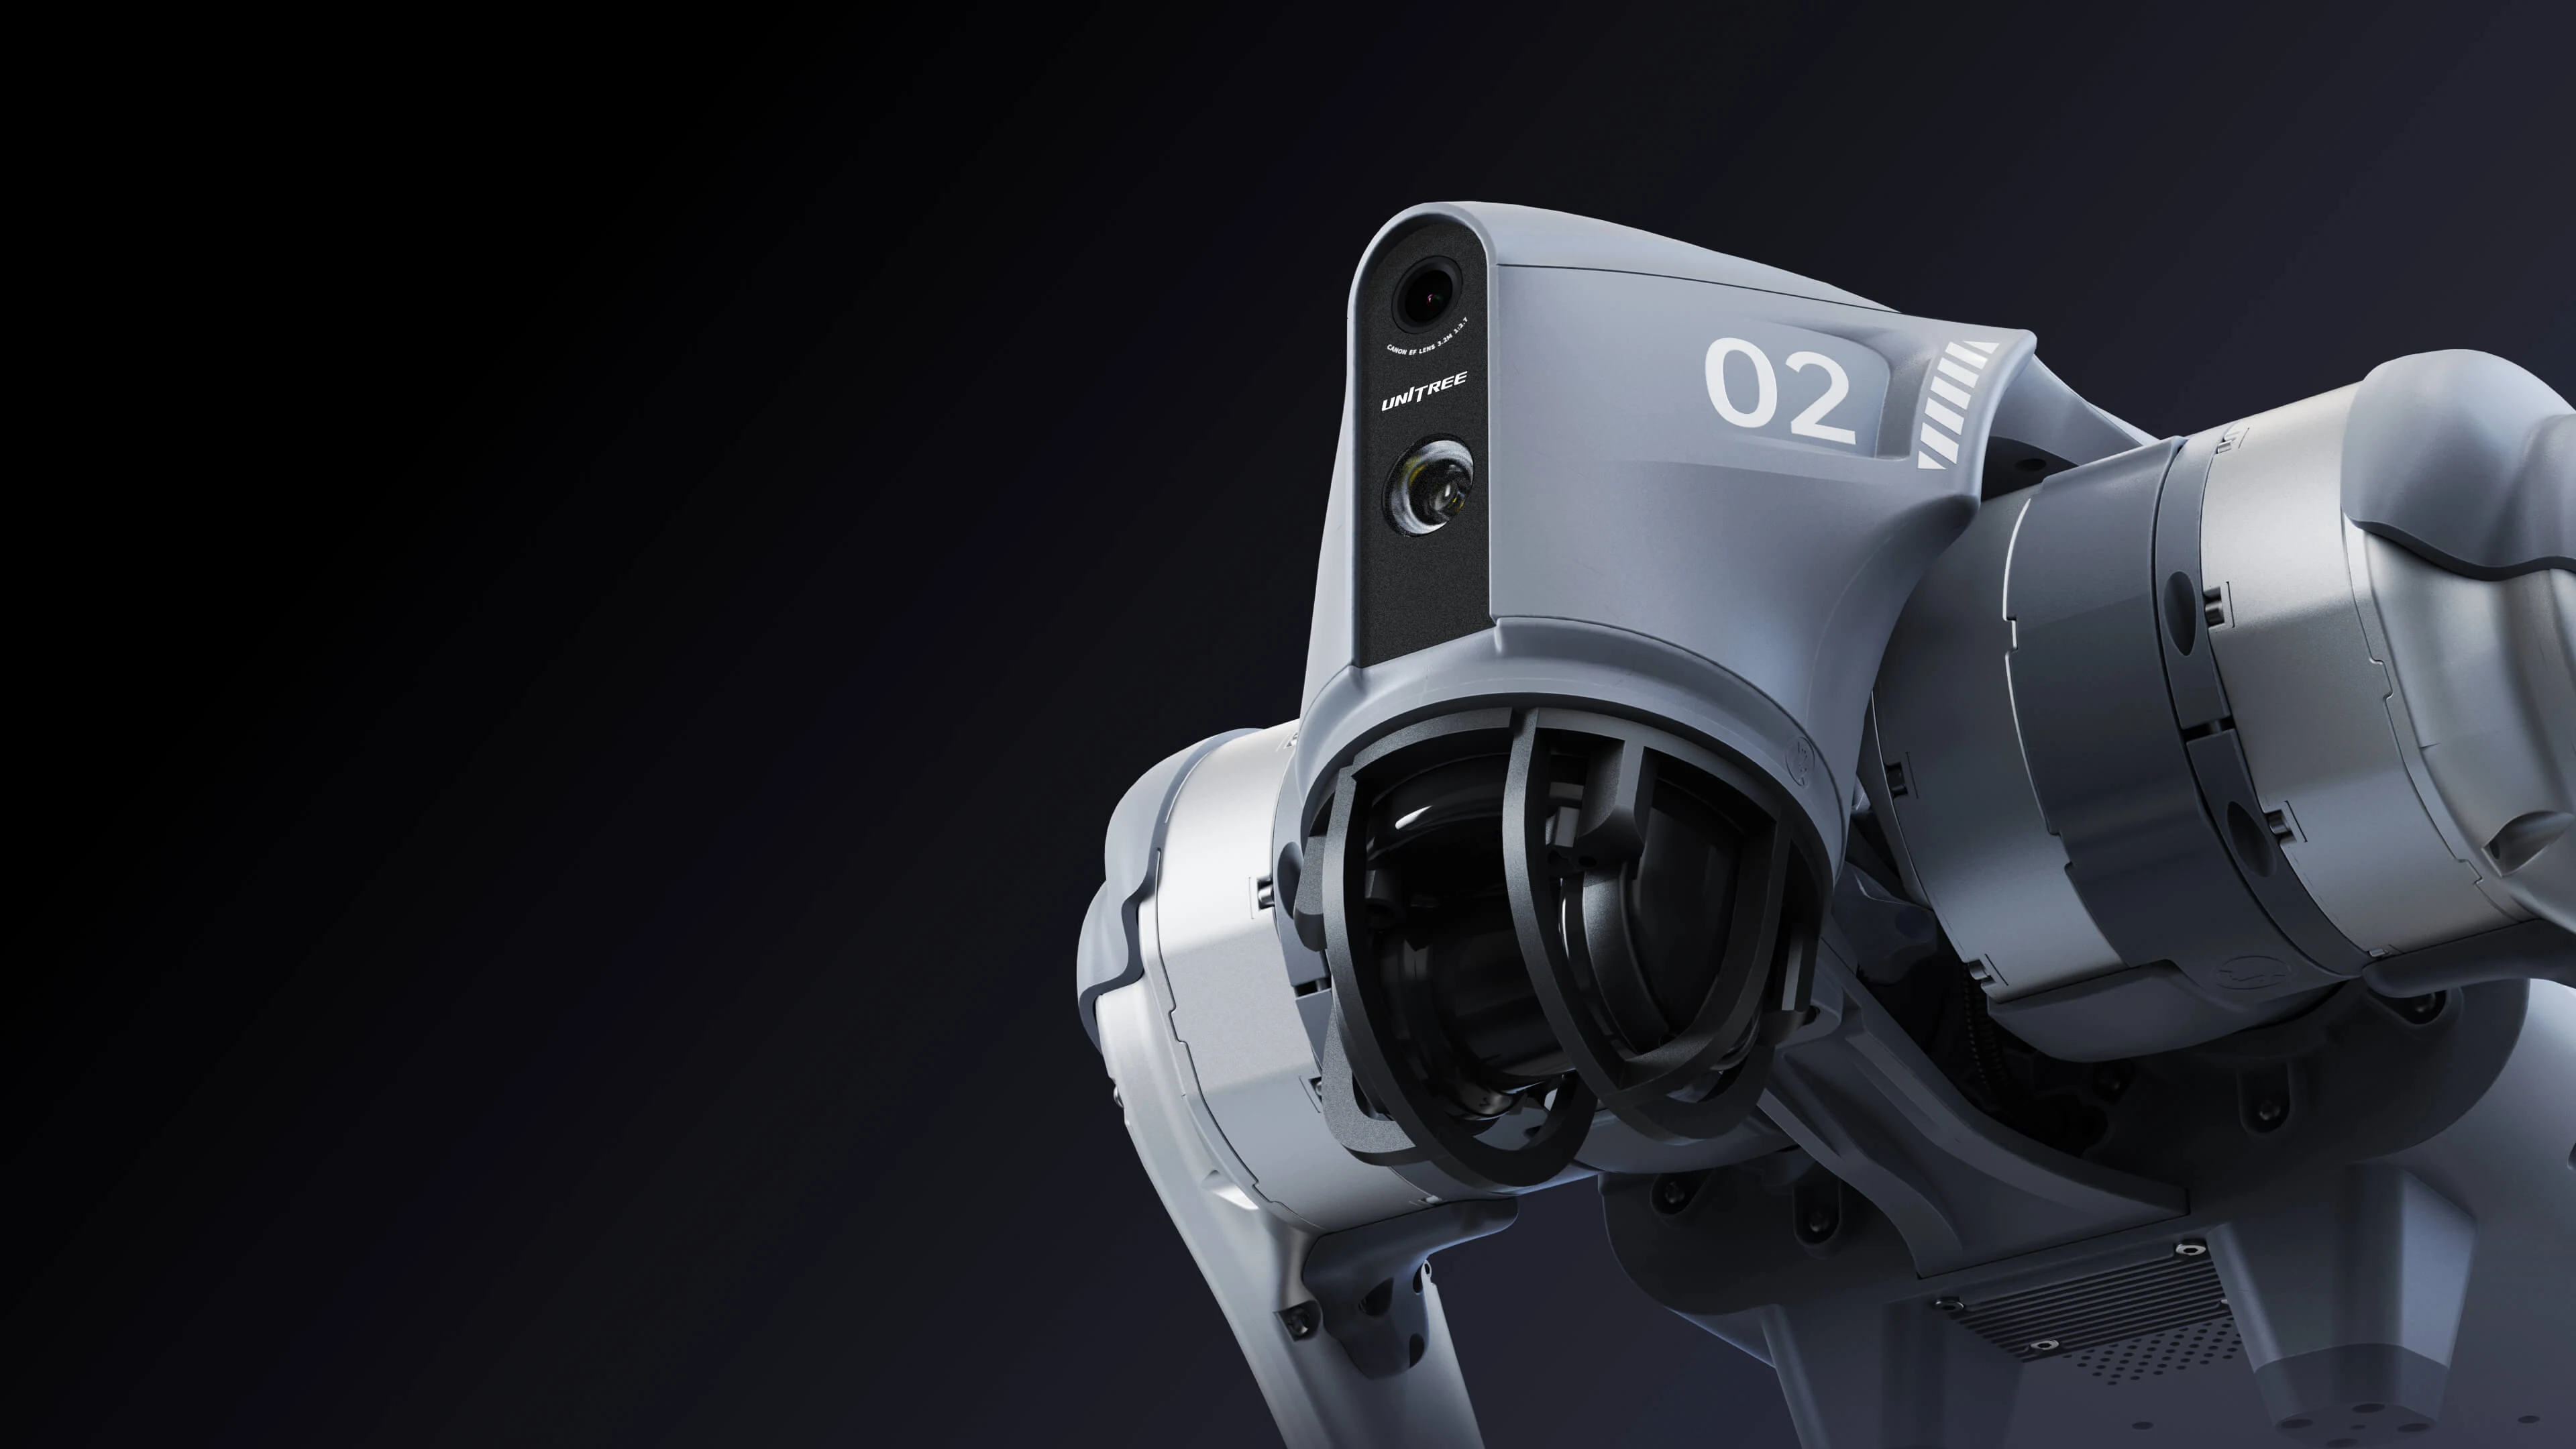
获得实验所需的访问能力
LiDAR、开发支持和可选算力扩展;开放能力因版本而异。
研究视角: 选定平台前,确认能否访问所需的控制、传感器和计算功能。
图片:Unitree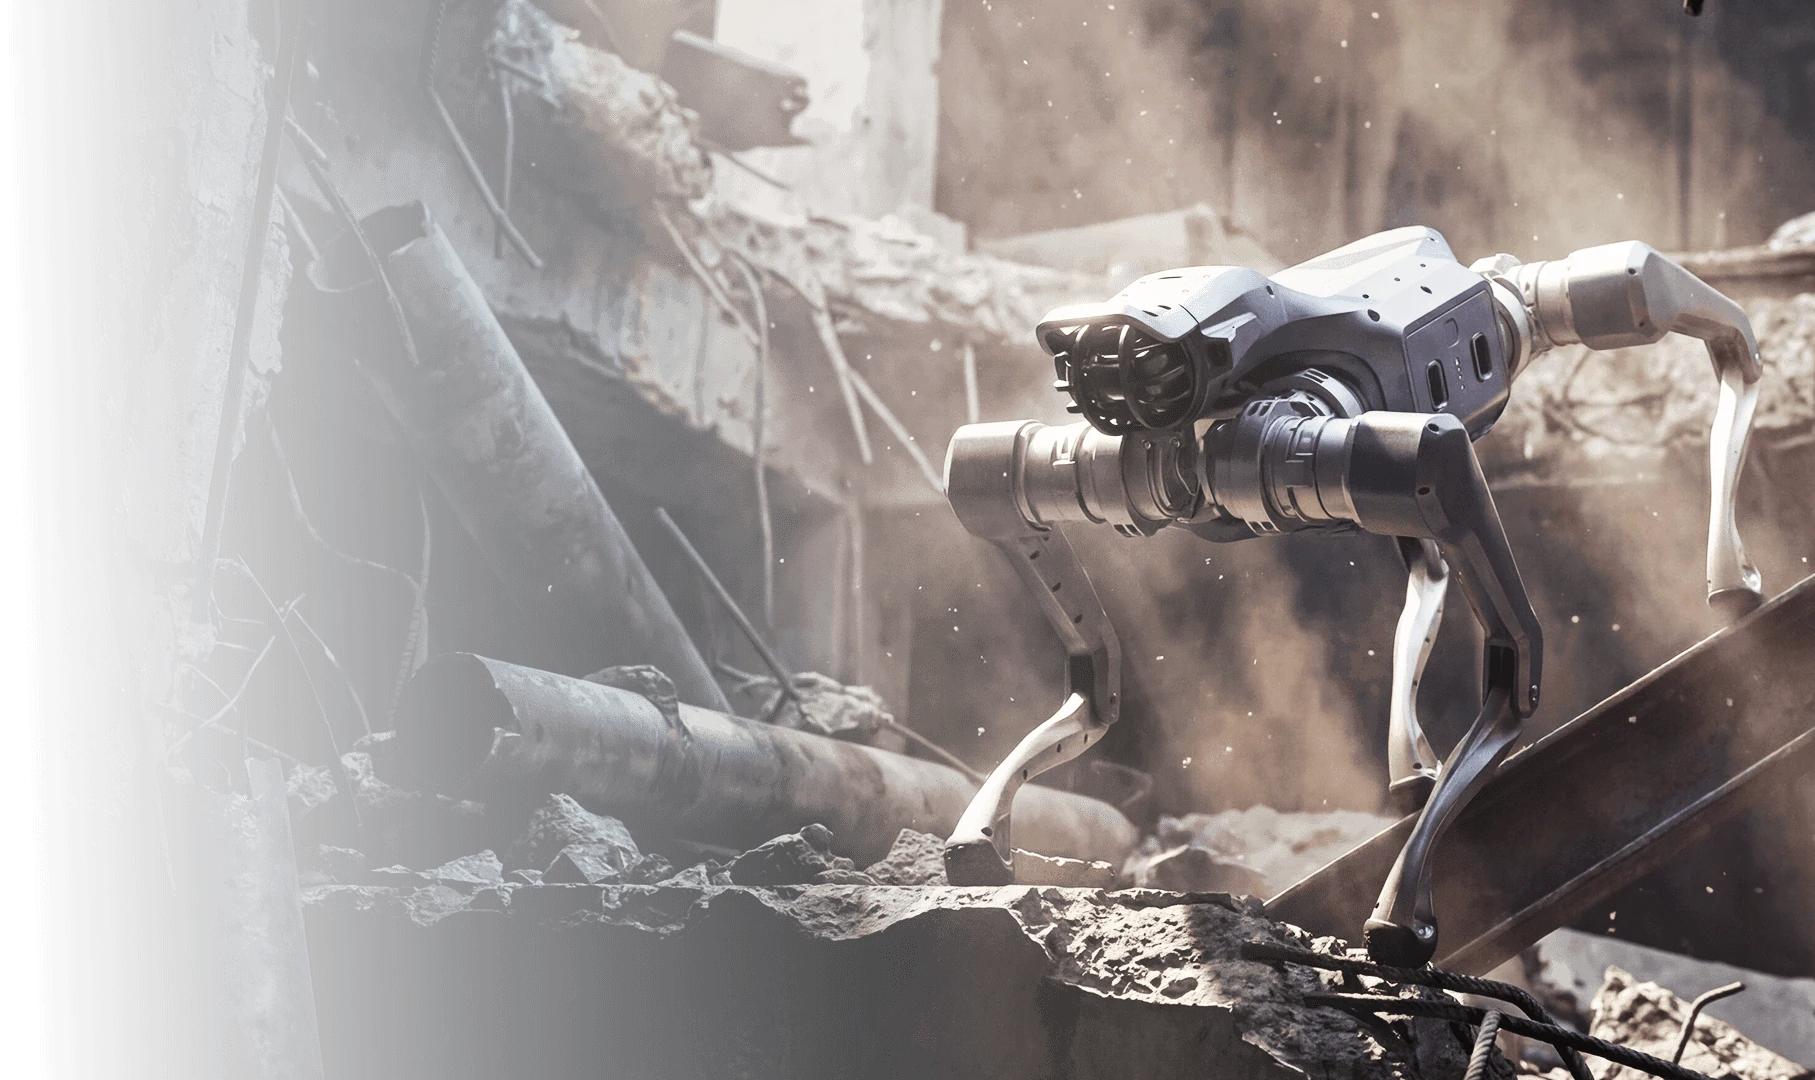
在预期运行条件下测试
开发支持、算力扩展和 EDU 对接站。部分展示功能仍在开发中。
研究视角: 在预期工作负载下评估已提供的能力。
图片:Unitree厂商图片和说明核对于 2026 年 9 月 24 日。产品配置可能不同;研究启示为我们自己的分析。
商用平台为移动和巡检提供了有价值的基础。我们自建平台,是为了获得实验所需的直接访问能力:可以修改机械结构、测量其响应,并同步更新对应的仿真模型。
系统如何协同工作
我们提出的系统方案,将负责推理和导航的 PC 与机器人本体上的控制系统连接起来。LiDAR、机身运动感知和关节反馈,把规划的动作与机器实际遇到的情况联系起来。
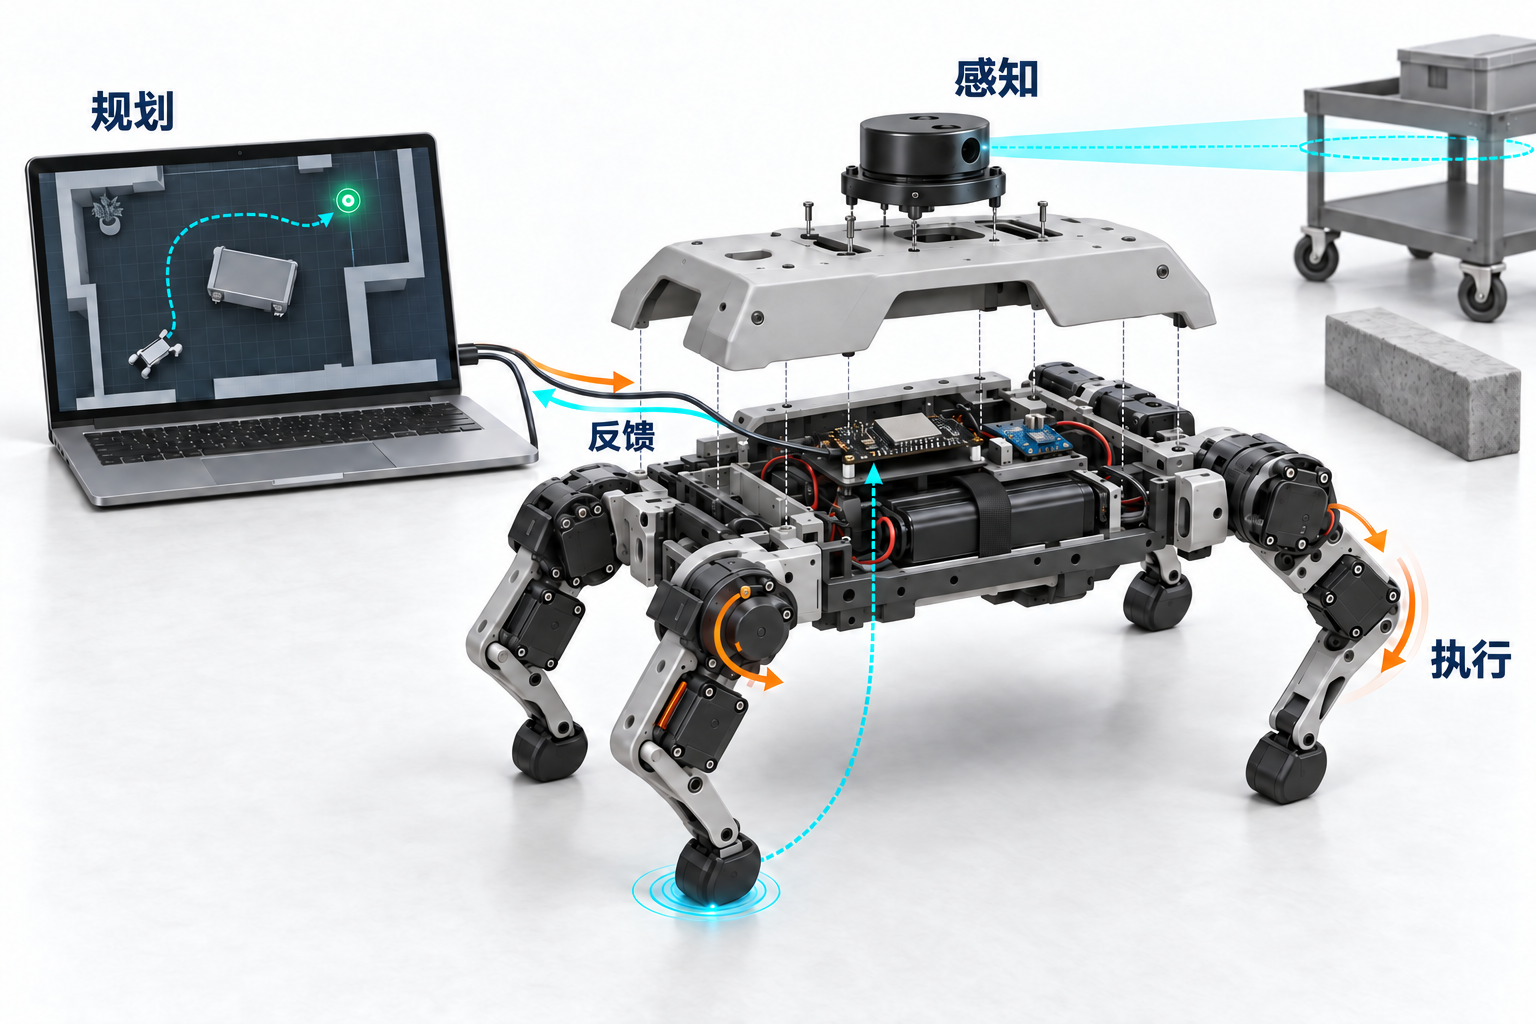
系统集成的关键问题包括:各模块需要哪些状态信息,延迟会怎样影响行为,以及观测不确定时应该如何调整计划。
行走应成为可复用的能力
“移动到下一个检查点”和“靠近一点”应当共用同一种移动能力。即使方向、支撑状态和地面条件发生变化,这种能力也应保持稳定。
实际运动与指令不一致时,运动控制策略必须利用机身和关节反馈,调整每一次动作。
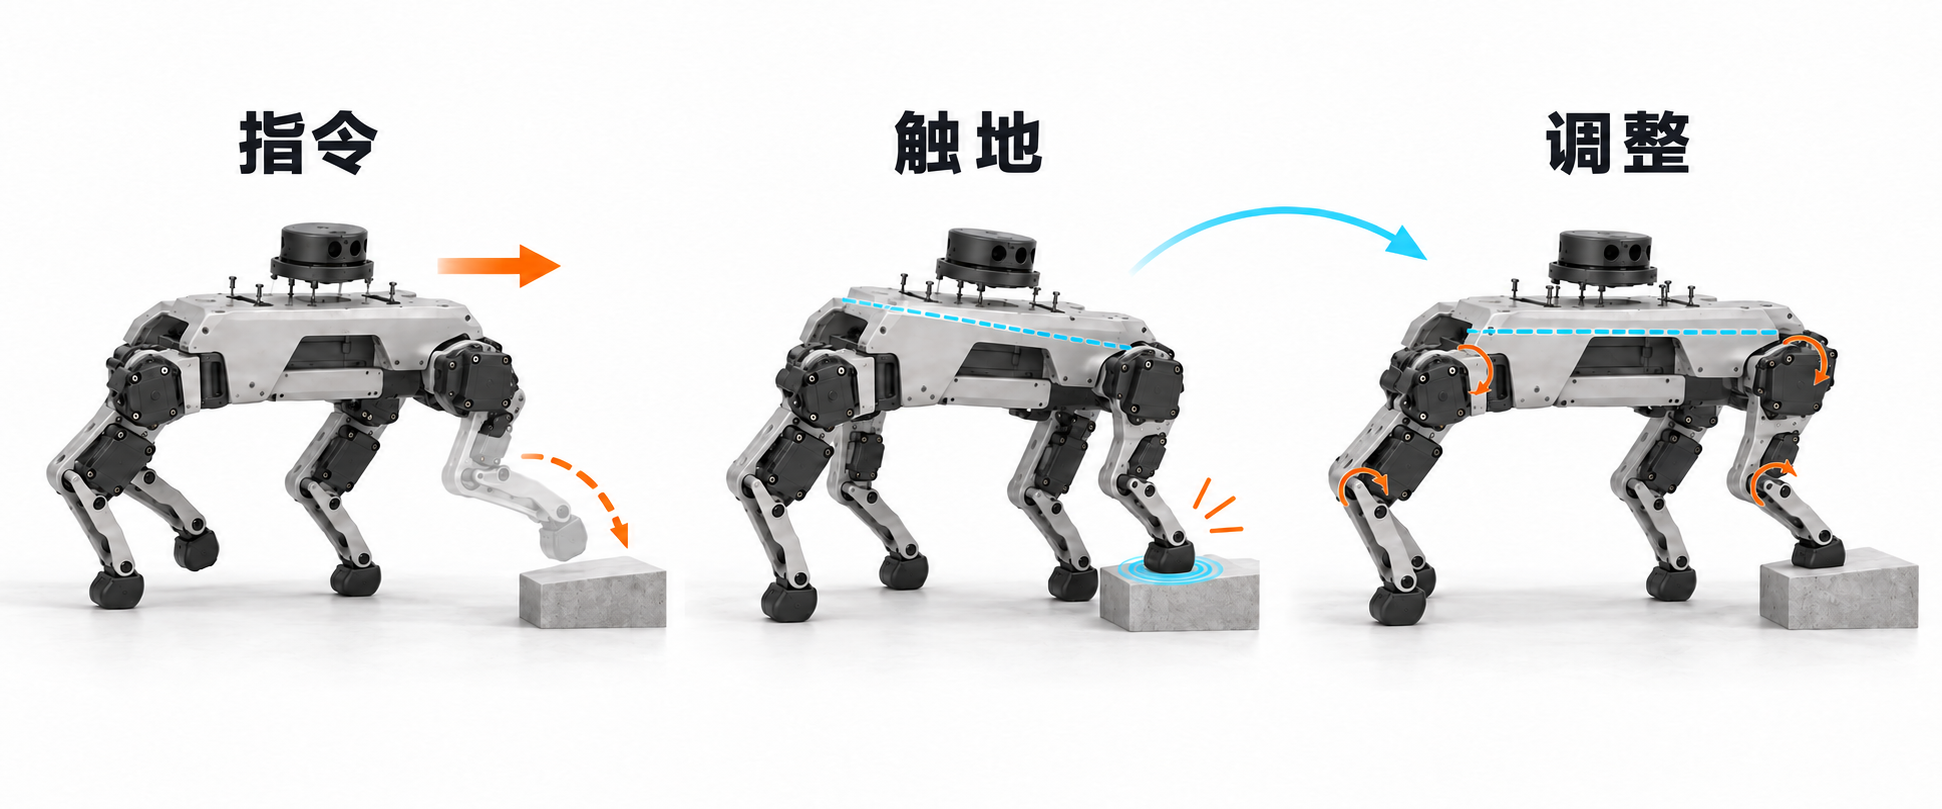
接触变化、不准确的状态估计和执行器延迟,都是这项能力必须承受的考验。
导航让移动服务于任务目的
基于 LiDAR 的建图与定位,可以帮助导航系统找到绕过推车的路线;行走能力则负责执行移动。Orion 的导航架构 是我们探索这种连接时参考的案例之一。
理解“检查那个压力表”还需要另一种能力:识别相关物体,确定任务需要什么观测结果。摄像头和能够理解图像与语言的模型,可能成为未来系统的一部分。当目标或路线不明确时,机器人需要识别这种不确定性,并请求帮助。
仿真帮助我们在不同条件下学习
仿真让我们能够在反复进行实机试验之前,先针对不同地面和扰动条件训练、测试运动能力。强化学习可以对遵循指定方向且保持稳定的行为给予奖励。
NVIDIA 的 Spot 运动控制案例 展示了如何在变化的仿真动力学条件下训练,再把得到的策略运行到硬件上。
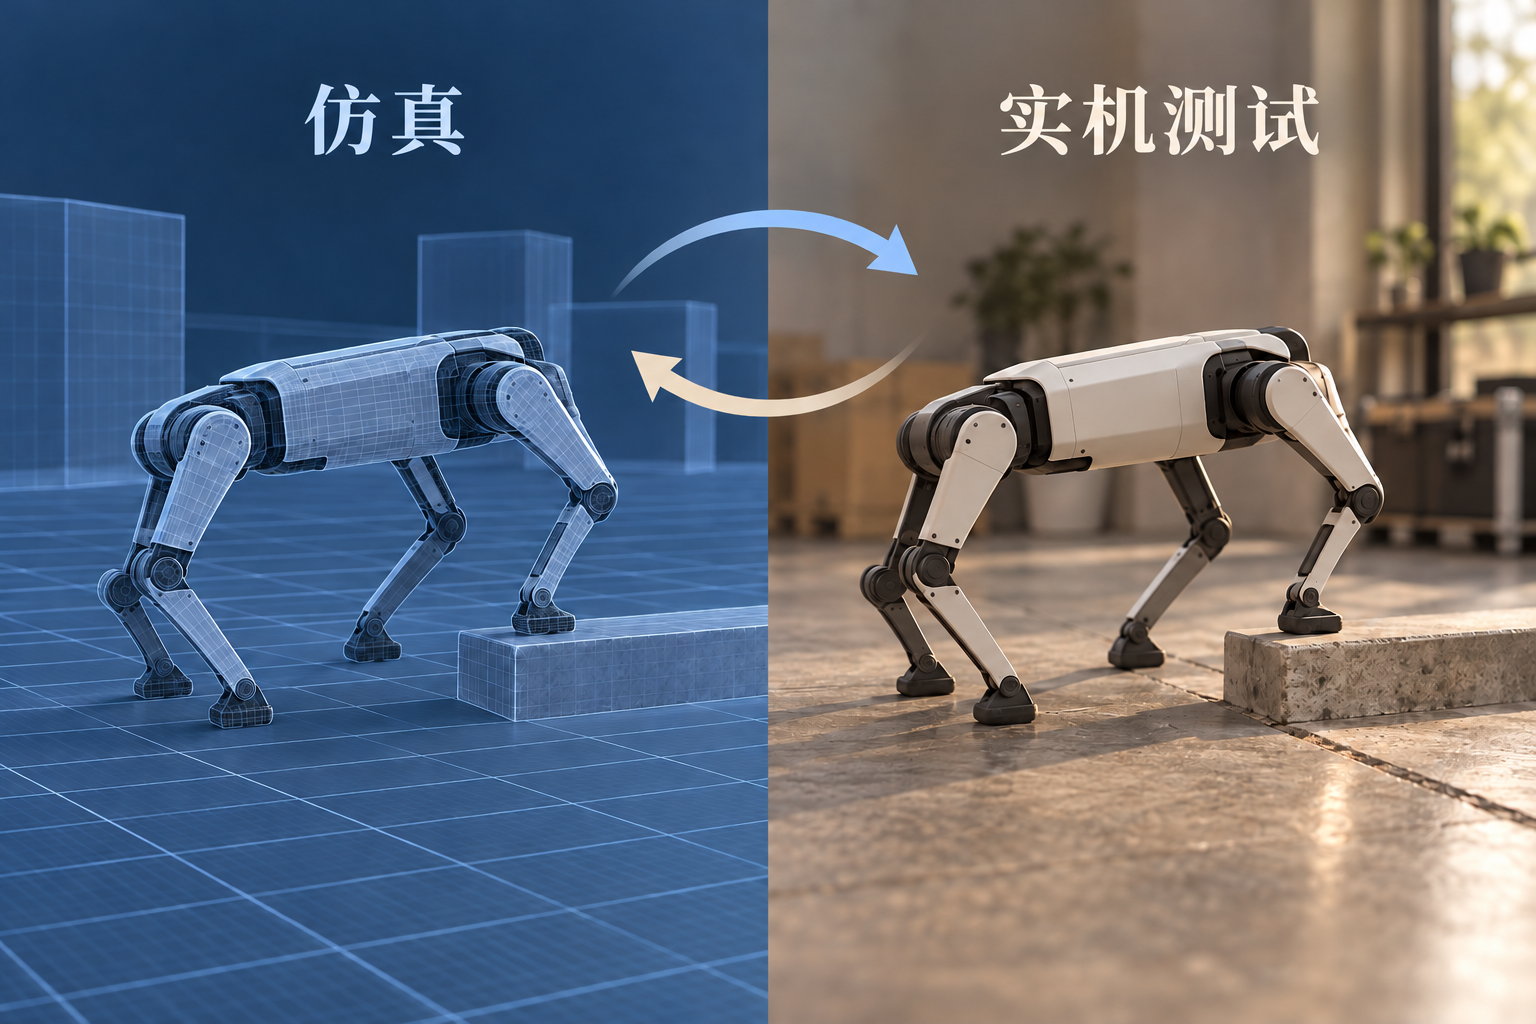
仿真到实机迁移的效果取决于模型误差:仿真中的足部可能抓地太牢,执行器也可能响应过快。实机试验能揭示这些差异,并为下一轮模型修正提供测量数据。
适应变化时,应复用机器人已有的能力
适应变化的第一步,是确定变的是什么:路线、目标,还是对某项物理能力的要求。
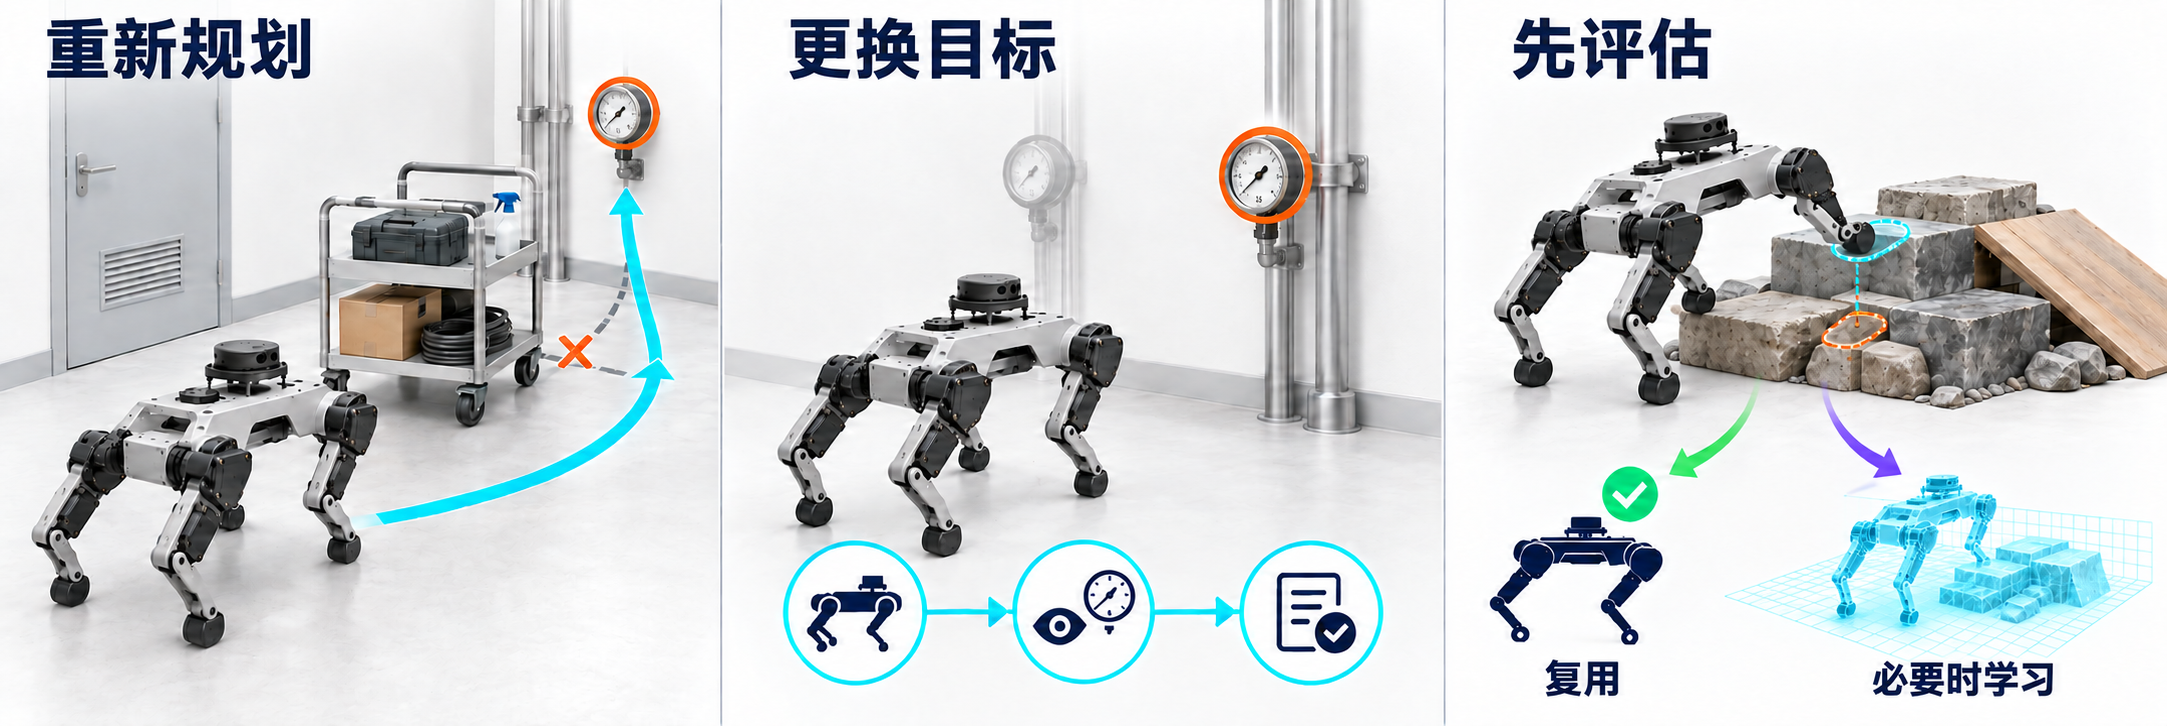
目标改变时,可以保留原有的动作顺序。如果任务需要另一种顺序,就要重新组合技能。陌生条件需要评估,但并不意味着一定要重新训练。
Open X-Embodiment 和 Physical Intelligence 的 π0.5 等研究,正在探索如何从更广泛的经验中学习,并泛化到新的环境。这些工作为我们提供方向参考,但不能证明任何机器人都能完成任意新任务。
我们希望研究的问题
第一个具体问题是:测量哪些物理量,能让在仿真中学到的运动在硬件上更可靠?
待行走平台准备就绪后,我们设想开展一项对比实验:一种策略在初始仿真器中训练,另一种则在根据关节响应和地面接触测量数据校准后的仿真器中训练。让移动任务、策略设计和训练资源投入保持可比,有助于单独考察校准的影响。
随后,两种策略将面对同一组未用于训练的实机条件。我们会比较任务稳定完成情况、运动跟踪误差和人工干预情况,以检验模型改进能否在校准条件之外也提高迁移效果。
更广泛的问题仍然包括:不确定的观测应如何影响计划,已有技能何时能用于新任务,以及机器人何时应该请求帮助。这些问题把受控实验与可靠完成整项任务的最终目标联系起来。
项目仍处于早期原型阶段:数字化腿部设计和电子部件选型已经准备好;实机行走、集成导航,以及针对这台机器人的已训练策略,都尚待验证。
项目参考:TNY-360 和 Orion 为我们的研究方向提供了参考。腿部设计根据 TheRobotStudio 的 SO101 几何模型 改造,在其 Apache 2.0 许可证 下修改了底座和腿部下段。