本文內容
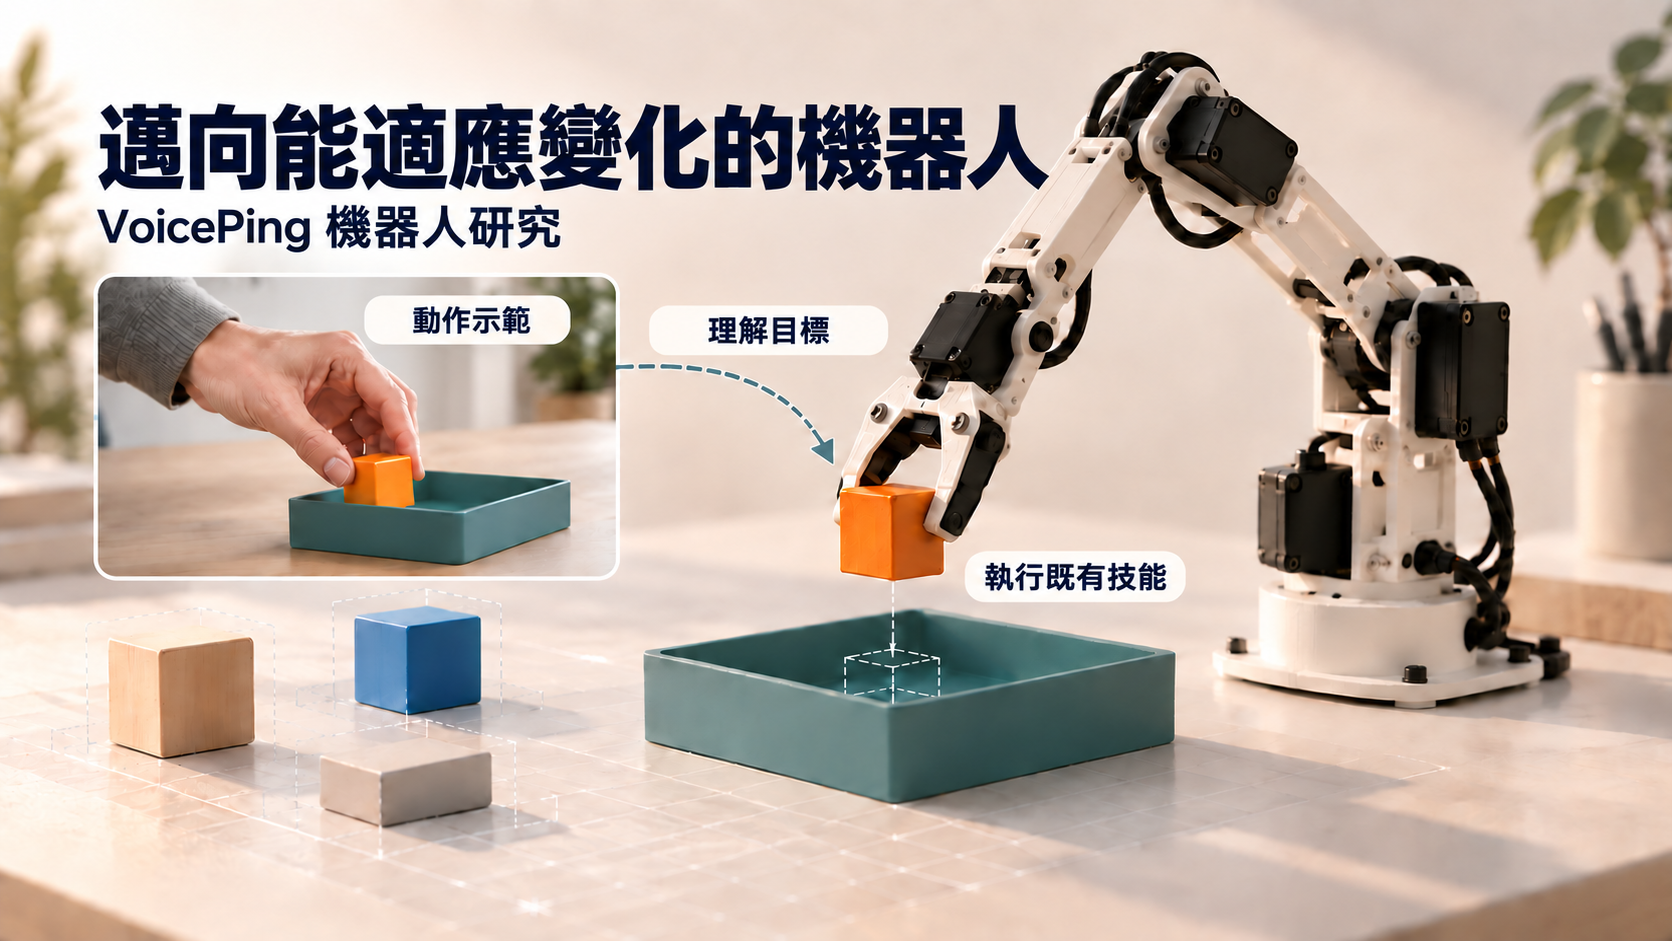
VoicePing 的長期目標,是打造能理解有用的任務、在實體世界中行動,並在情況改變時作出調整的機器人。如果每換一個房間、一條路線,或遇到一點變化,都得個別訓練,就很難擴大部署規模。
機器狗專案提供了一個研究平台,讓我們探索機構設計、感測與學習式控制如何支撐這個目標,以及它們在實機試驗中會遇到哪些限制。
有用的機器人必須應對情況變化
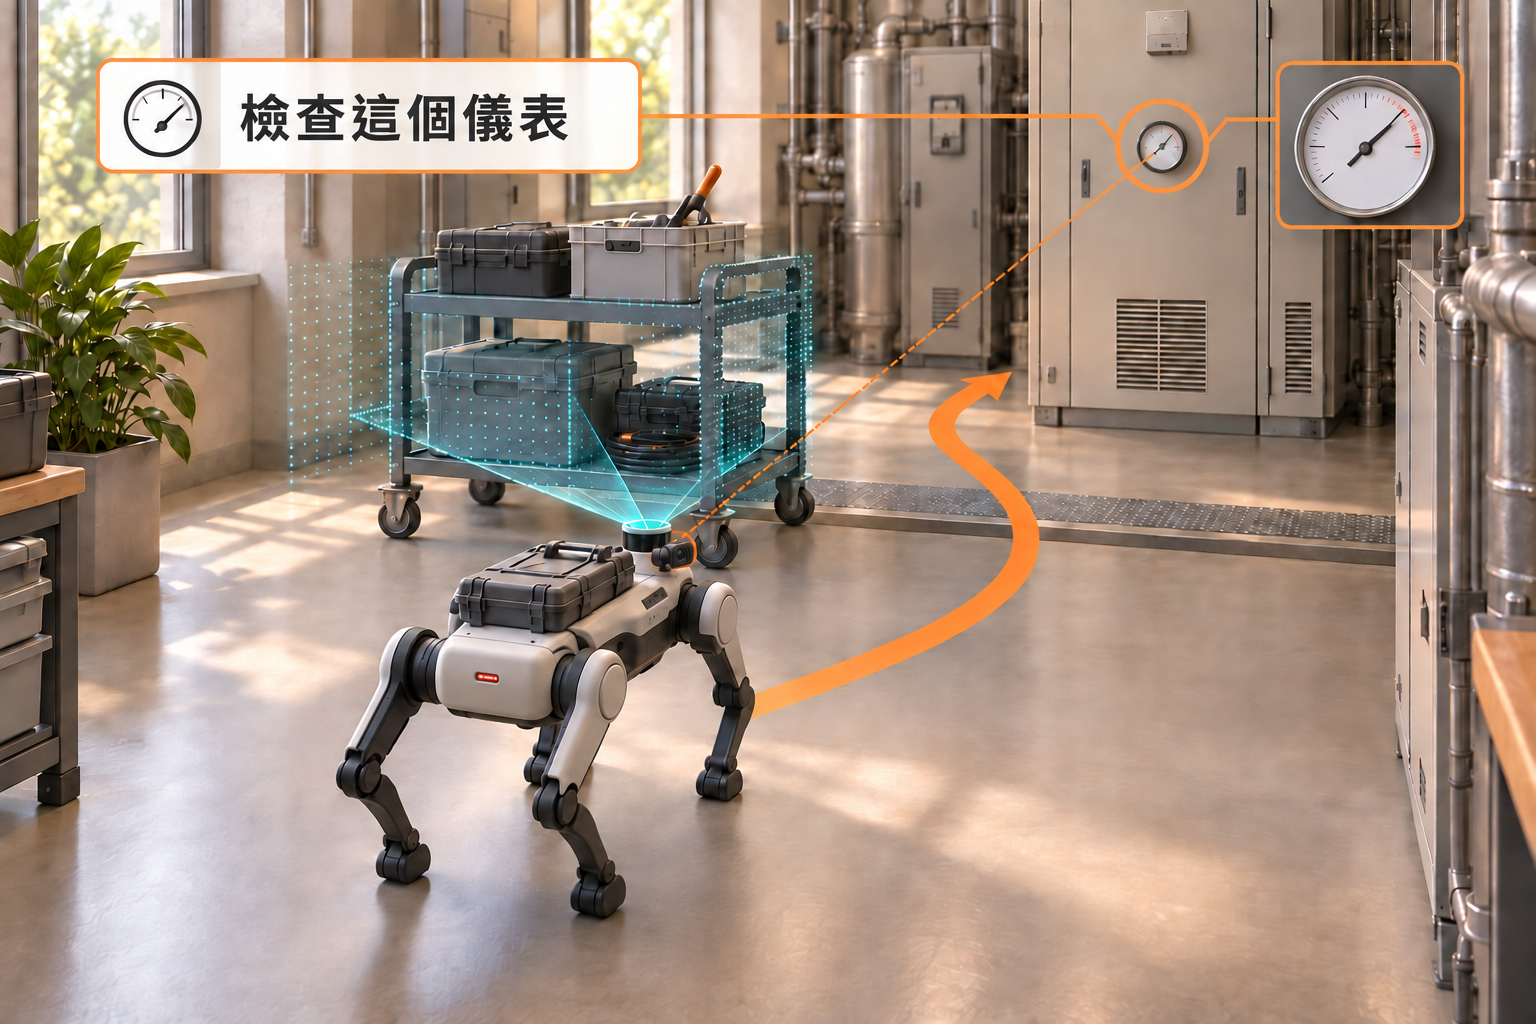
以室內巡檢為例:機器人需要前往某台設備,觀測其狀態,並回報需要留意的問題。
推車擋住路線時,需要重新規劃路徑。如果巡檢目標改變了,就需要更多判斷:把指令與正確的物體連結起來,確定應該觀測什麼。抵達目的地只是工作的一部分。
成功完成任務,意味著取得正確的觀測結果,並辨識何時需要人的協助。
為什麼機器狗適合作為研究平台
四足平台把平衡、不斷改變的地面接觸,以及移動中的感測器放進同一項實驗。致動器反應或機身運動估計中的微小誤差,都可能影響每一步。
能夠直接調整機構與控制系統,才能將這些誤差與設計選擇連結起來,並改進模擬器。我們想了解,量測哪些物理量可以讓學到的行為更可靠地轉移到實機。
最終用於客戶情境的機器人,應採用適合任務的機身形式。這個平台協助我們建立作出這項選擇所需的方法。
商用機器狗:Spot、ANYmal 與 Unitree
商用四足機器人讓我們看見實際部署中值得關注的四個面向:
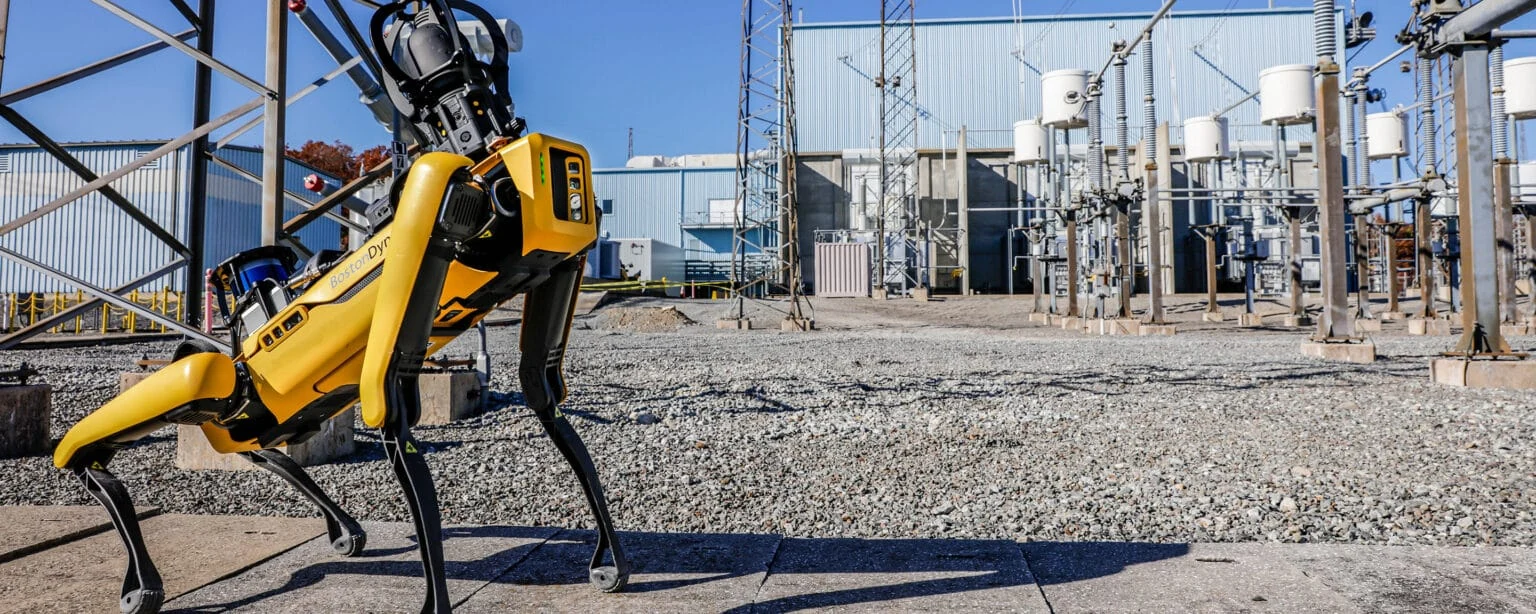
完成整個巡檢流程
自主執行任務、可配置的酬載,以及 Orbit 機器人群組管理。
研究觀點: 評估觀測結果是否有用,以及是否已準備好執行下一項任務。
圖片:Boston Dynamics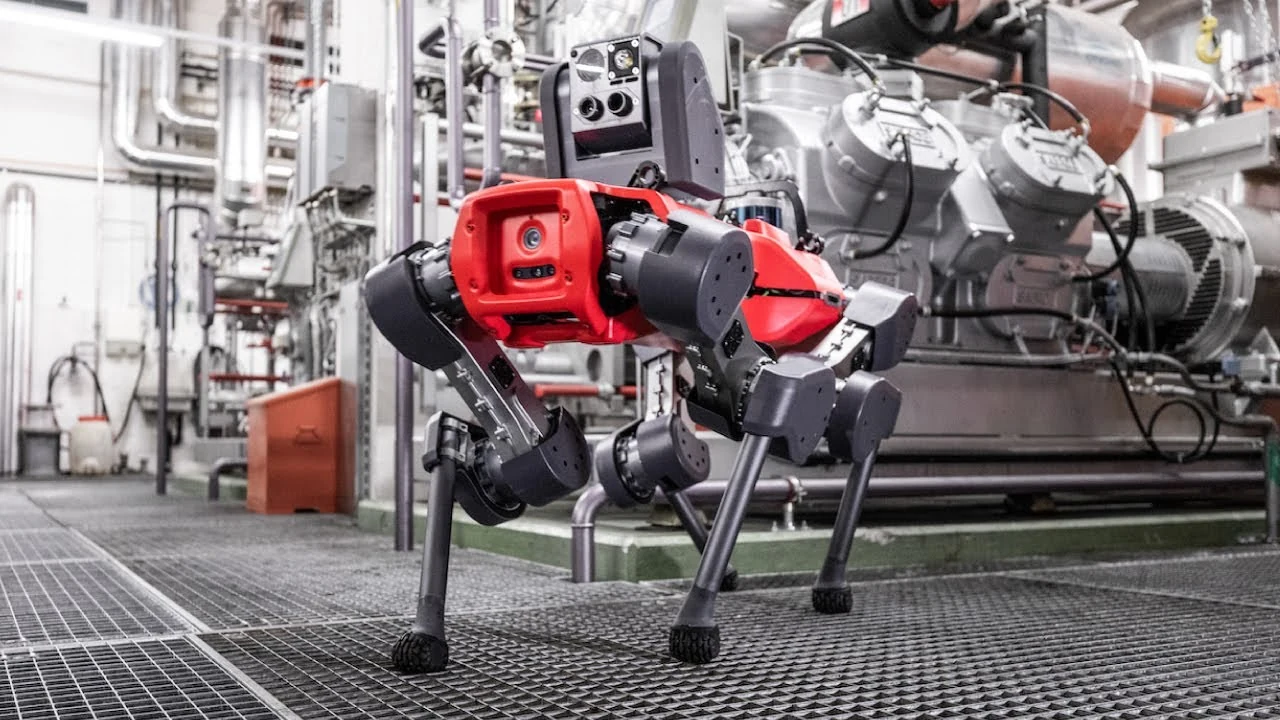
觀測真正需要的狀態
視覺、熱影像與聲學巡檢,搭配自主導航及對接。
研究觀點: 讓感測方式符合任務需求,並檢查重複觀測的一致性。
圖片:ANYbotics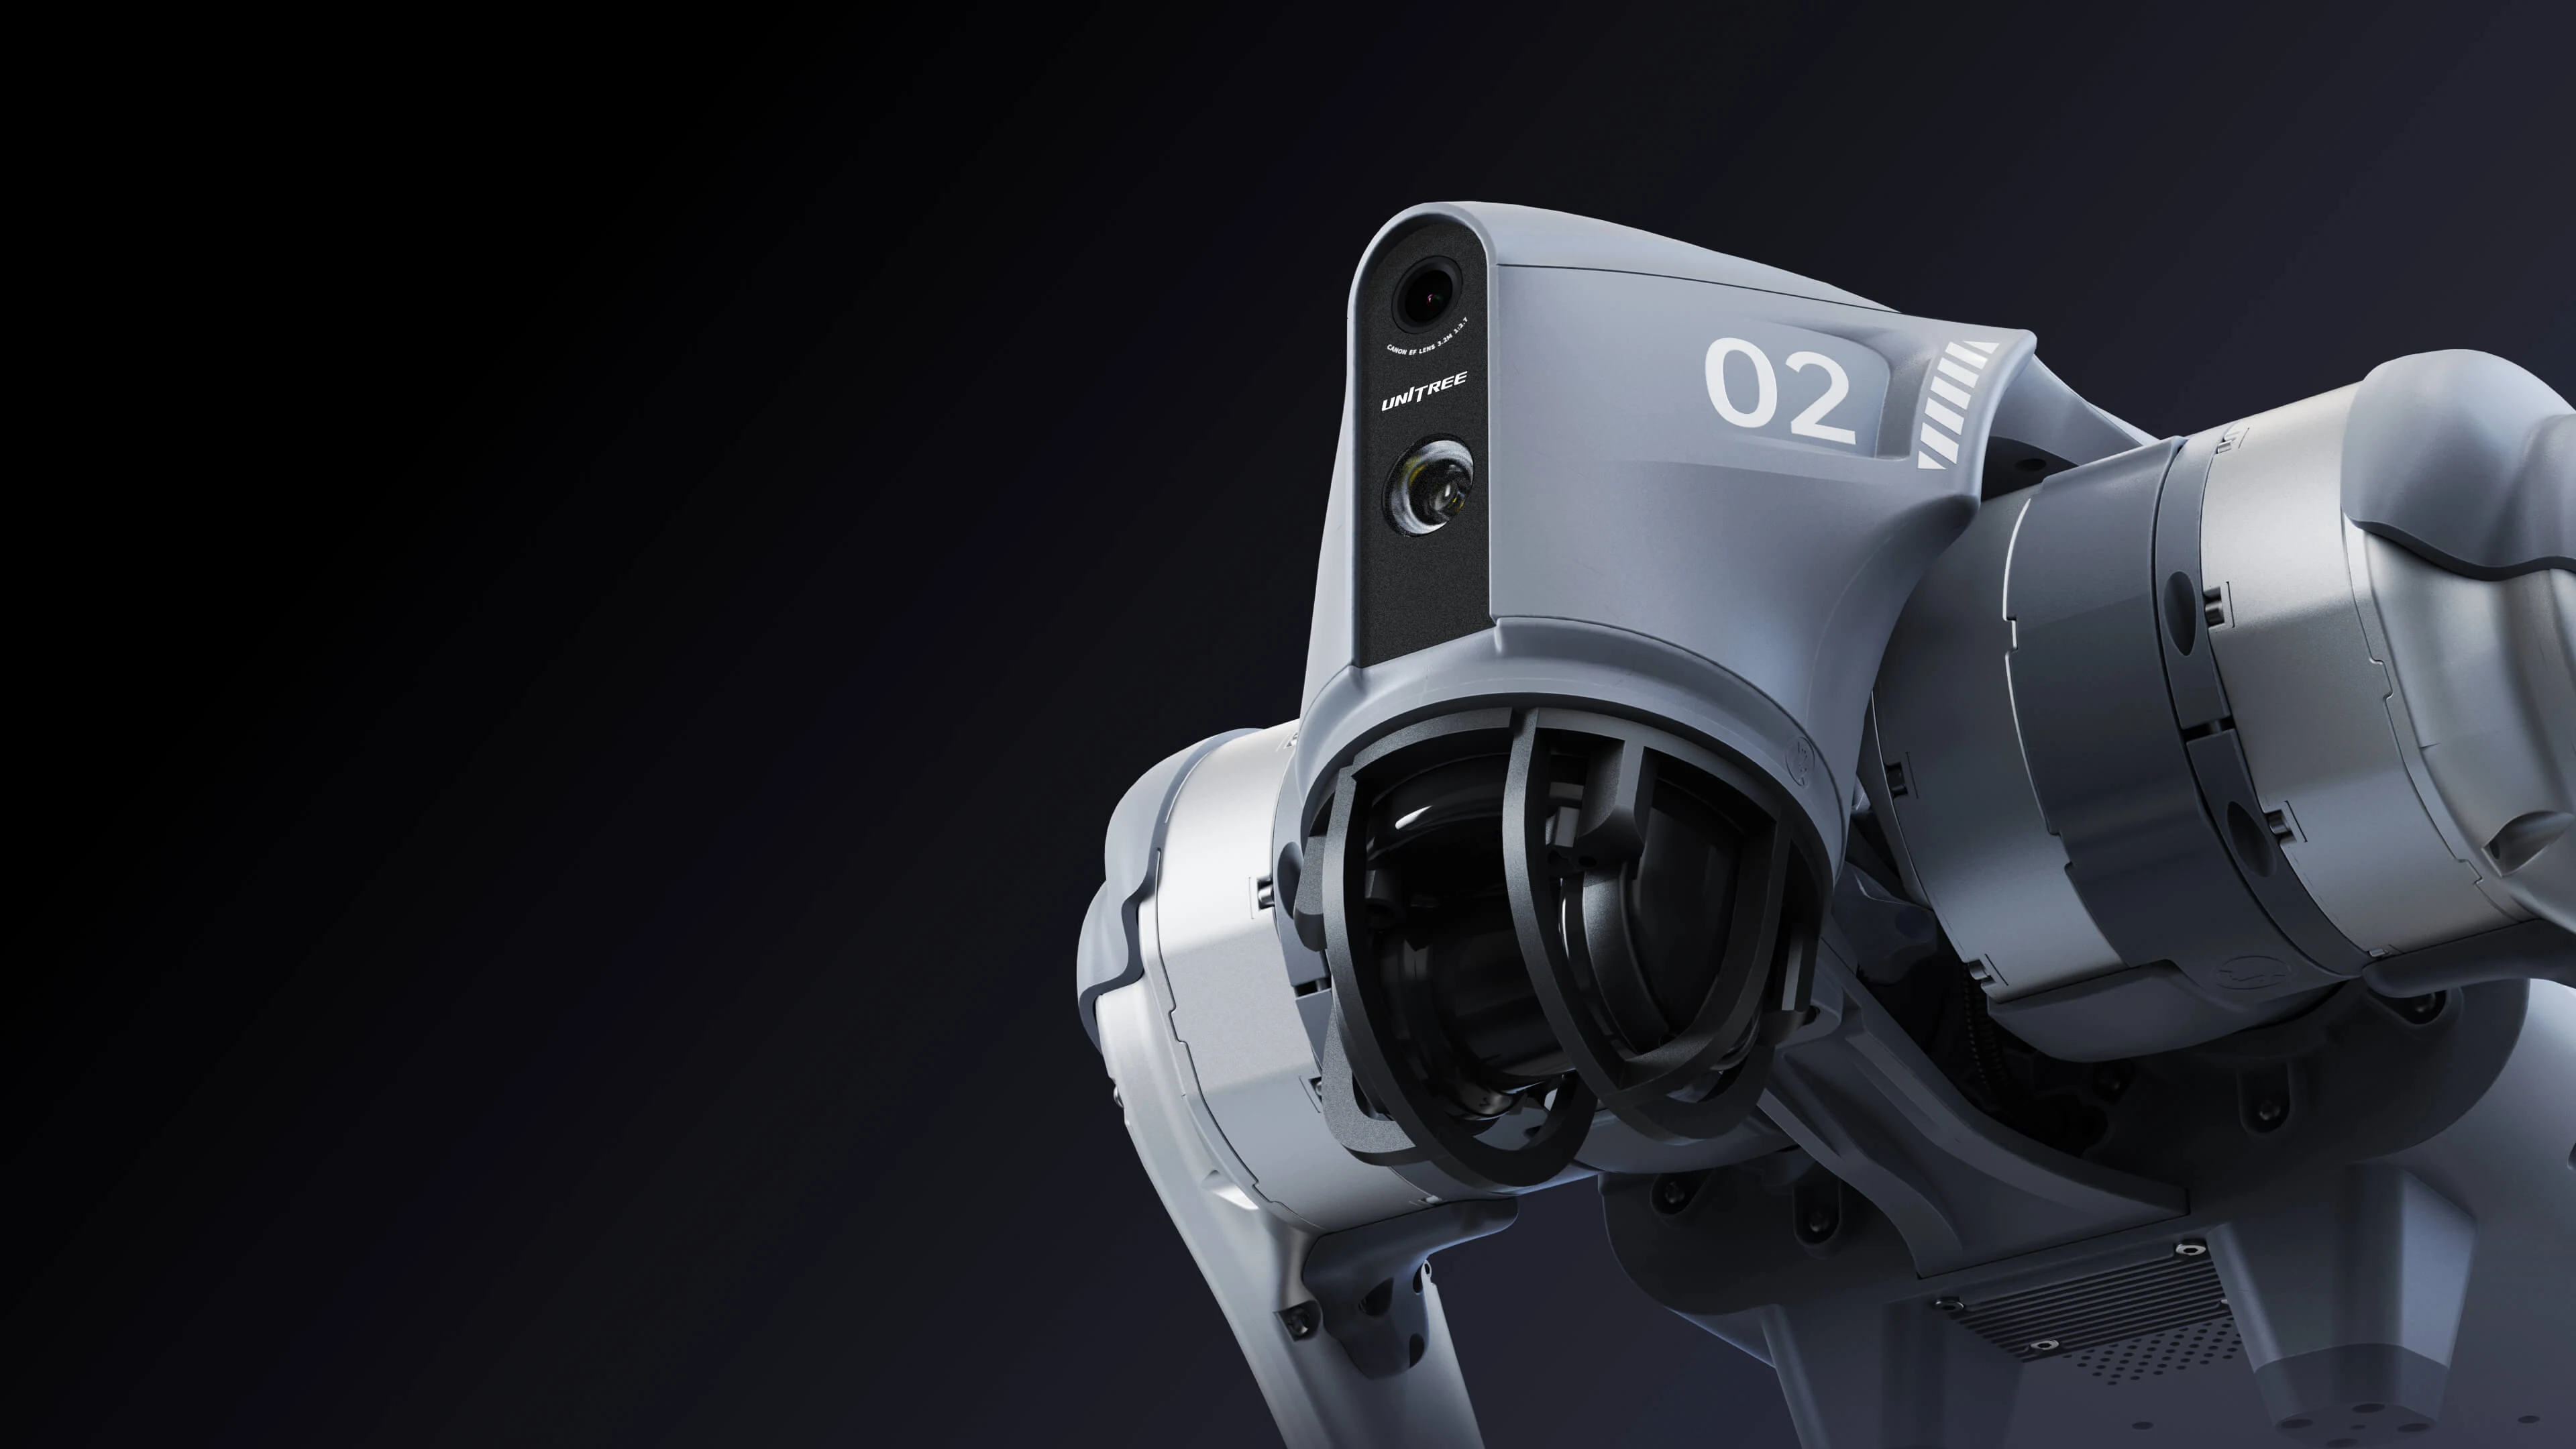
取得實驗所需的存取能力
LiDAR、開發支援與選配運算擴充;開放程度依版本而異。
研究觀點: 選定平台前,確認能否存取所需的控制、感測器與運算功能。
圖片:Unitree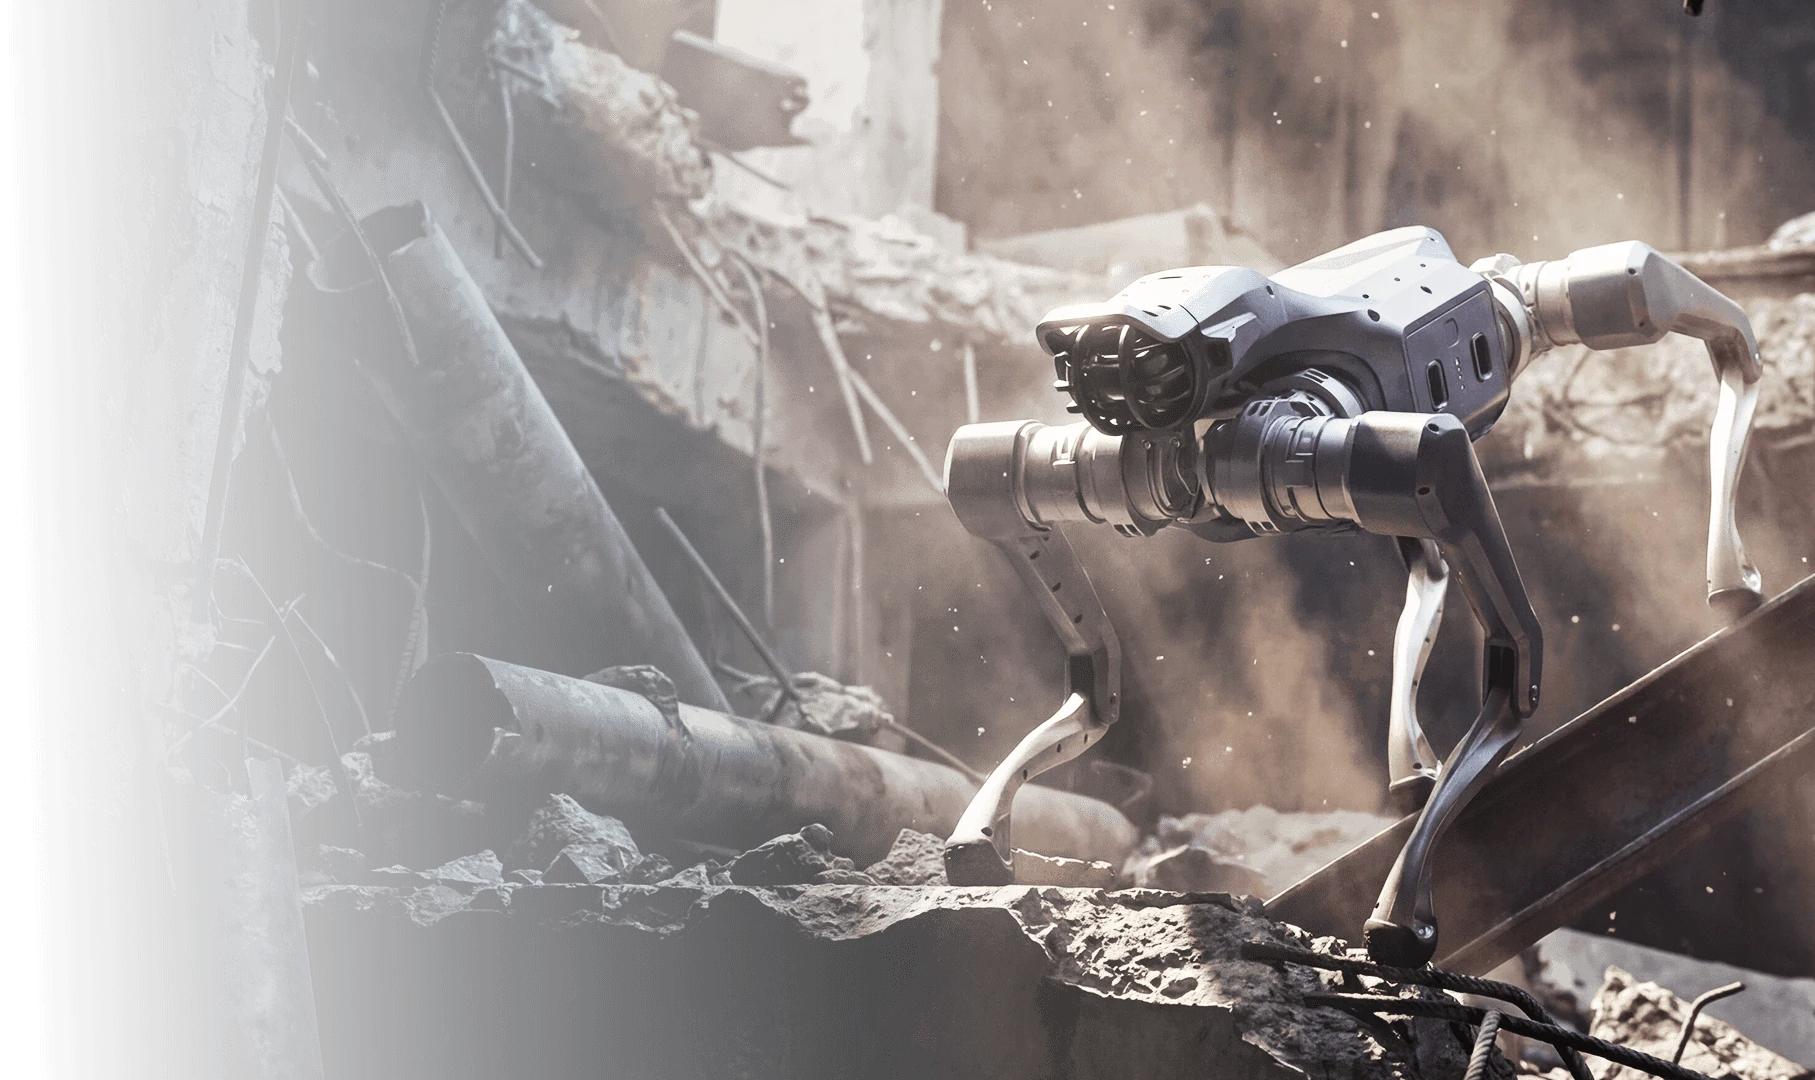
在預期運作條件下測試
開發支援、運算擴充與 EDU 對接站。部分展示功能仍在開發中。
研究觀點: 在預期工作負載下評估目前已提供的能力。
圖片:Unitree廠商圖片與說明於 2026 年 9 月 24 日核對。產品配置可能不同;研究啟示為我們自己的分析。
商用平台為移動與巡檢提供了有價值的基礎。我們自建平台,是為了取得實驗所需的直接存取能力:可以修改機構、量測反應,並同步更新對應的模擬模型。
系統如何協同運作
我們提出的系統方案,將負責推論與導航的 PC 連接到機器人本體上的控制系統。LiDAR、機身運動感測與關節回饋,把規劃的動作與機器實際遇到的情況連結起來。
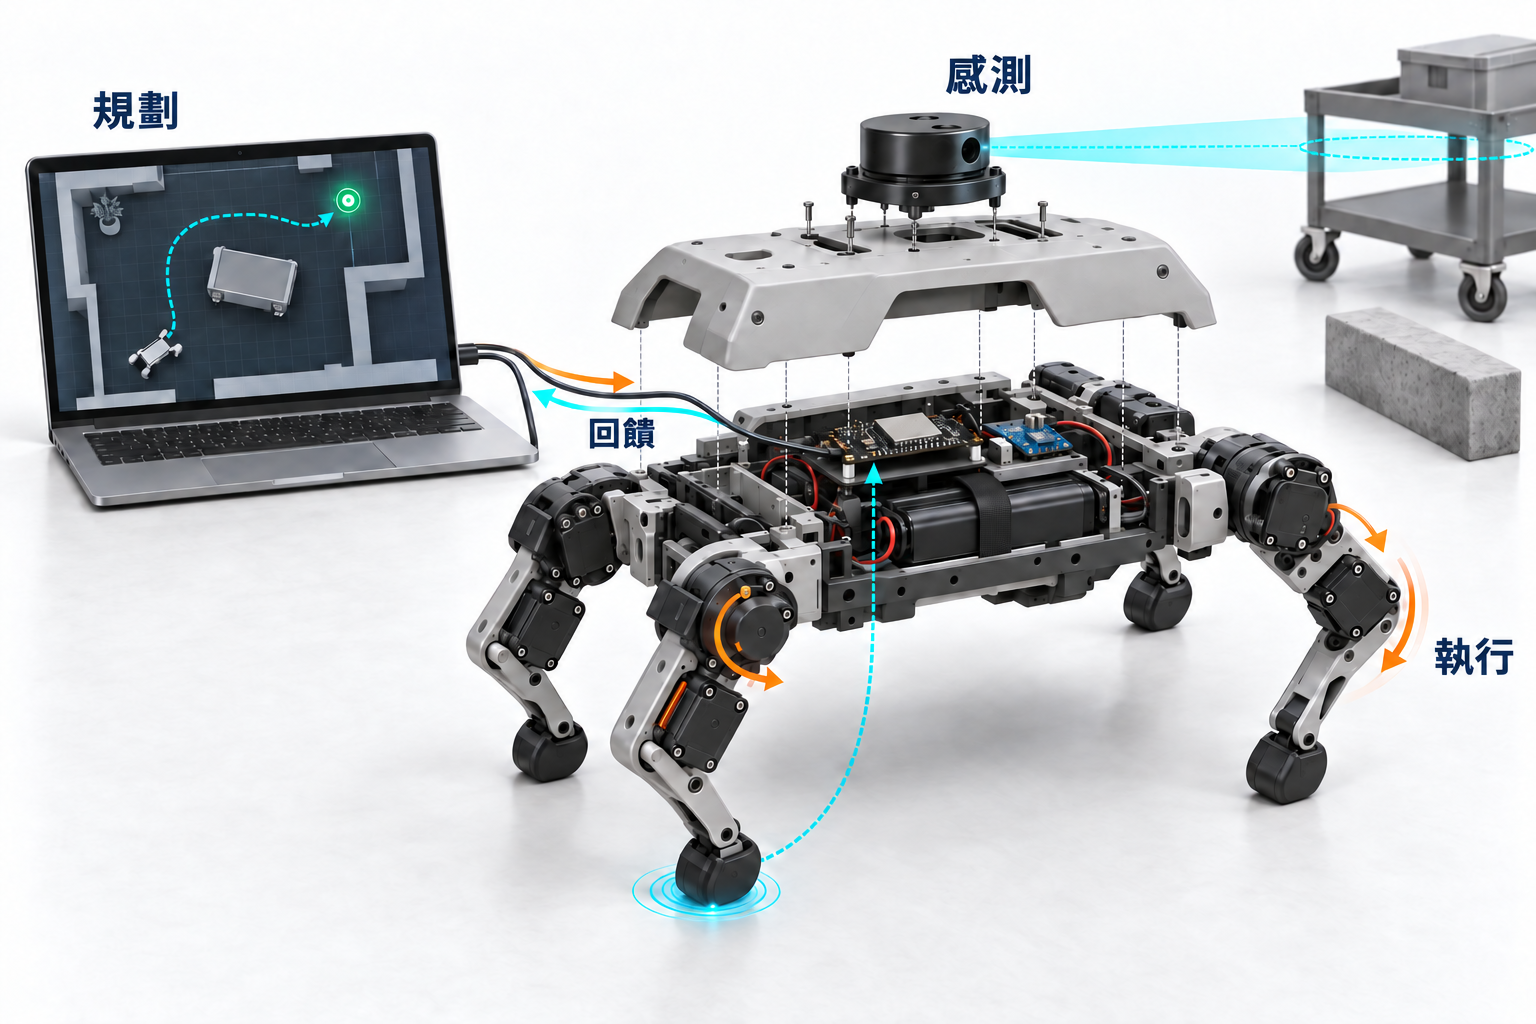
系統整合的關鍵問題包括:各模組需要哪些狀態資訊、延遲會如何影響行為,以及觀測不確定時應如何調整計畫。
行走應成為可重用的能力
「移動到下一個檢查點」與「靠近一點」應共用同一種移動能力。即使方向、支撐狀態與地面條件改變,這項能力也應保持穩定。
實際運動與指令不一致時,運動控制策略必須運用機身與關節回饋,調整每一次動作。
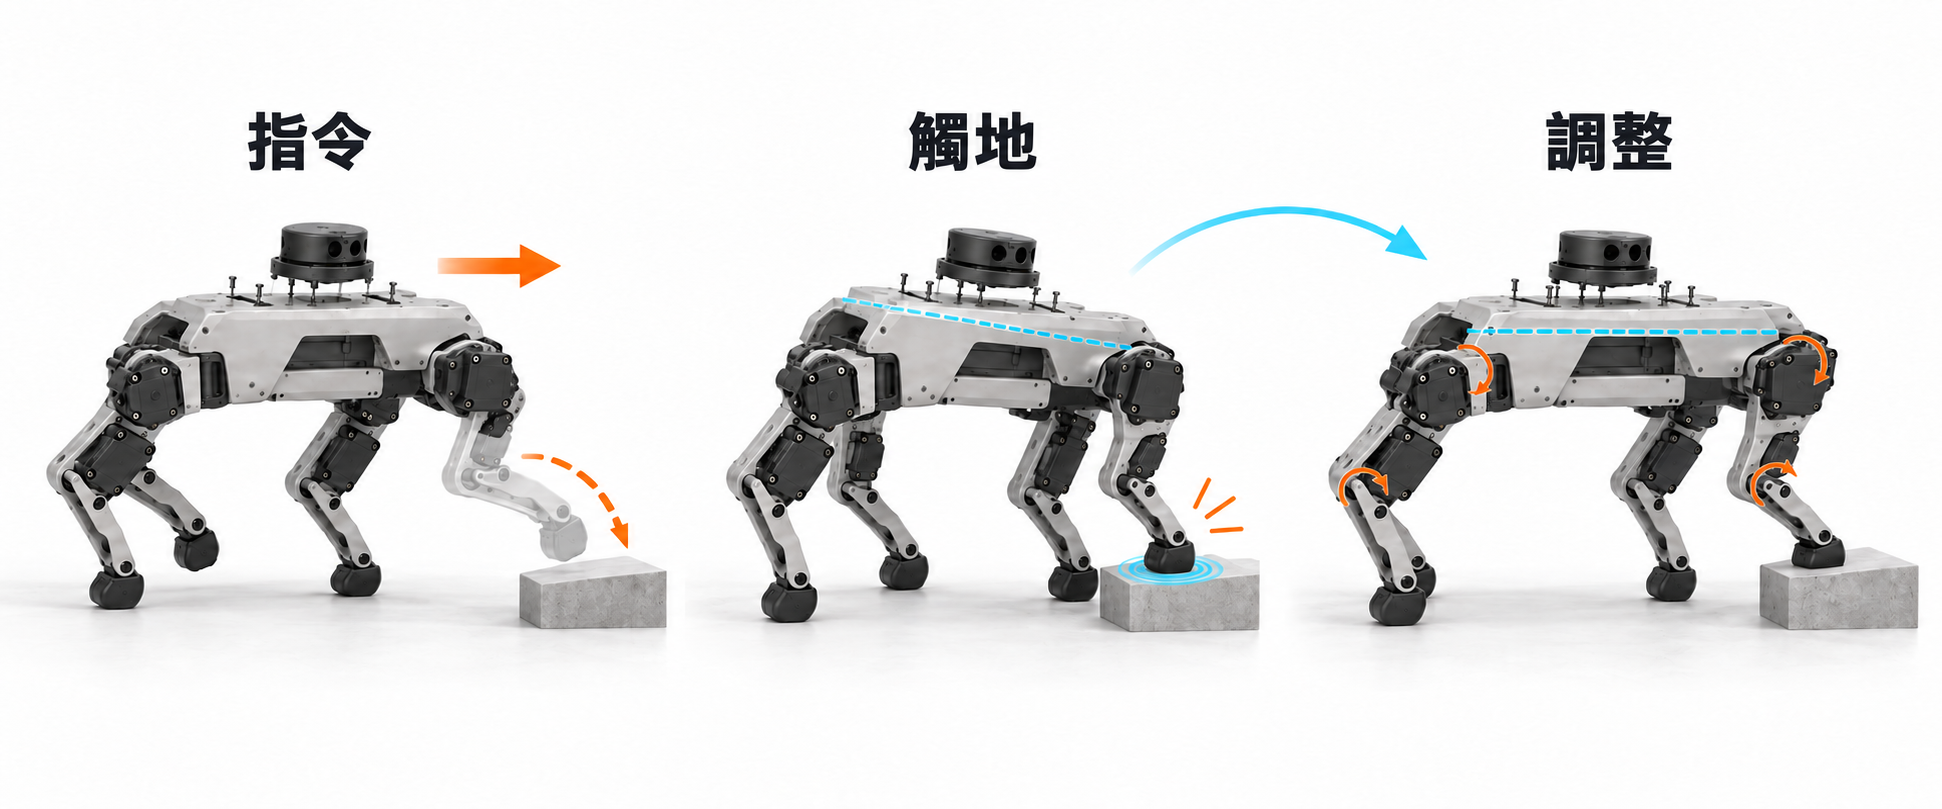
接觸變化、不準確的狀態估計與致動器延遲,都是這項能力必須承受的考驗。
導航讓移動服務於任務目的
以 LiDAR 為基礎的建圖與定位,可協助導航系統找出繞過推車的路線;行走能力則負責執行移動。Orion 的導航架構 是我們探索這種連結時參考的案例之一。
理解「檢查那個壓力表」還需要另一種能力:辨識相關物體,確定任務需要什麼觀測結果。攝影機與能理解影像及語言的模型,可能成為未來系統的一部分。目標或路線不明確時,機器人需要辨識這種不確定性,並請求協助。
模擬協助我們在不同條件下學習
模擬讓我們在反覆進行實機試驗之前,先針對不同地面與擾動條件訓練、測試運動能力。強化學習可以對遵循指定方向且保持穩定的行為給予獎勵。
NVIDIA 的 Spot 運動控制案例 展示了如何在不同的模擬動力學條件下訓練,再將得到的策略放到硬體上執行。
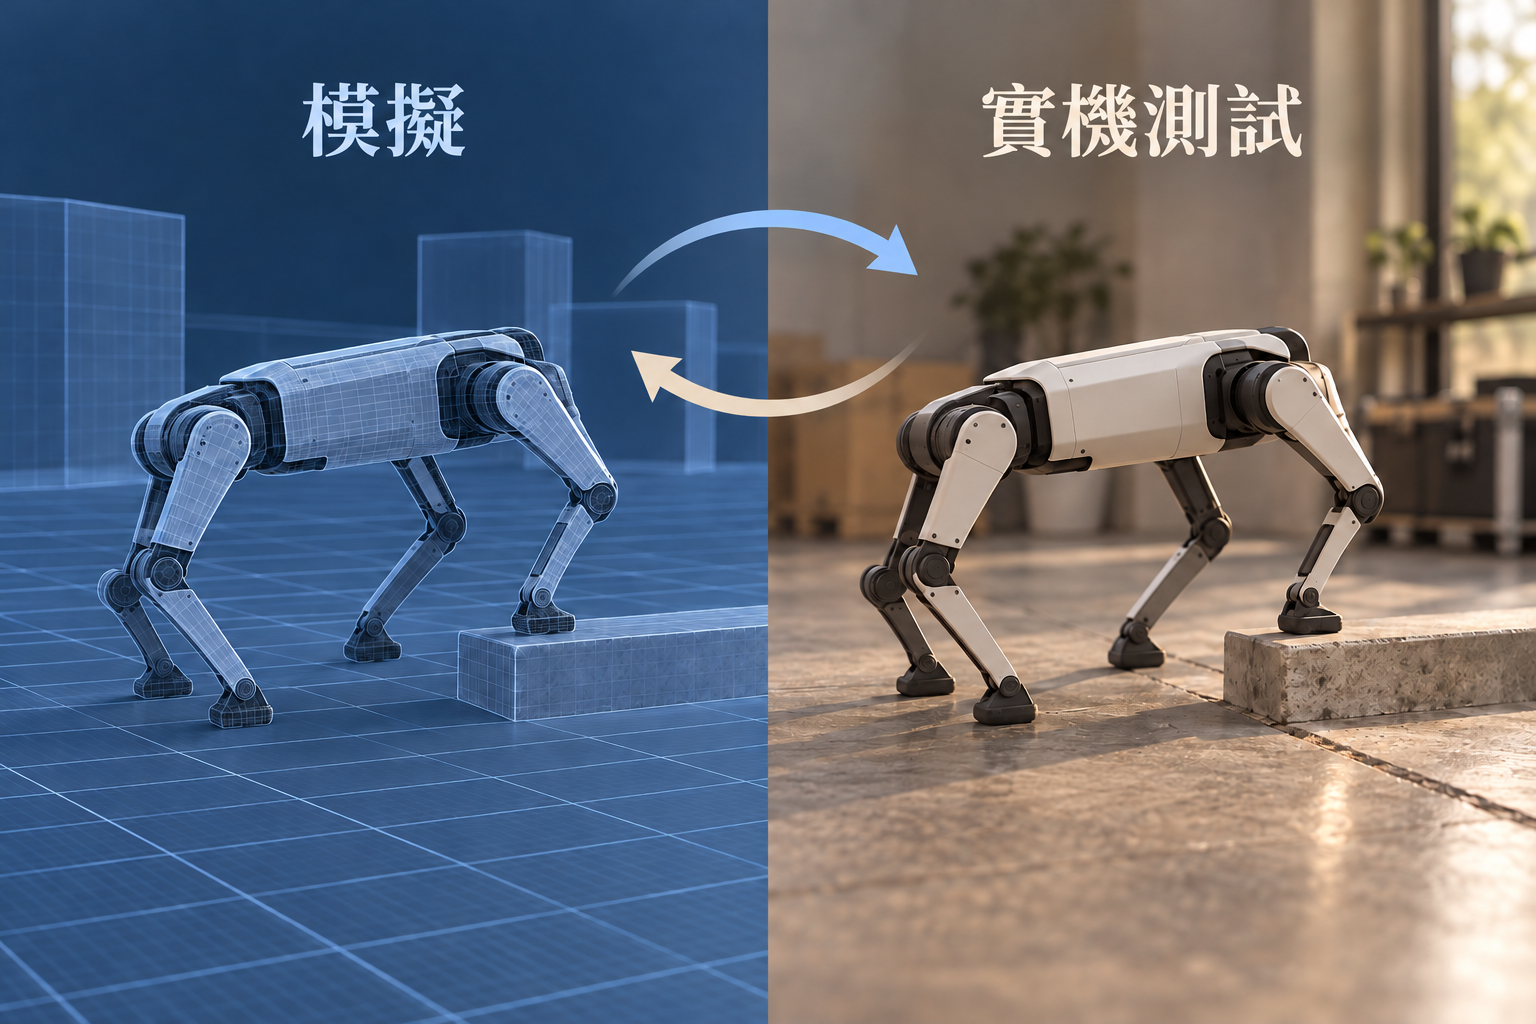
模擬到實機的轉移會受到模型誤差影響:模擬中的足部可能抓地太牢,致動器也可能反應過快。實機試驗能揭露這些差異,並為下一輪模型修正提供量測資料。
適應變化時,應重用機器人既有的能力
適應變化的第一步,是確認改變的是什麼:路線、目標,還是對某項物理能力的要求。
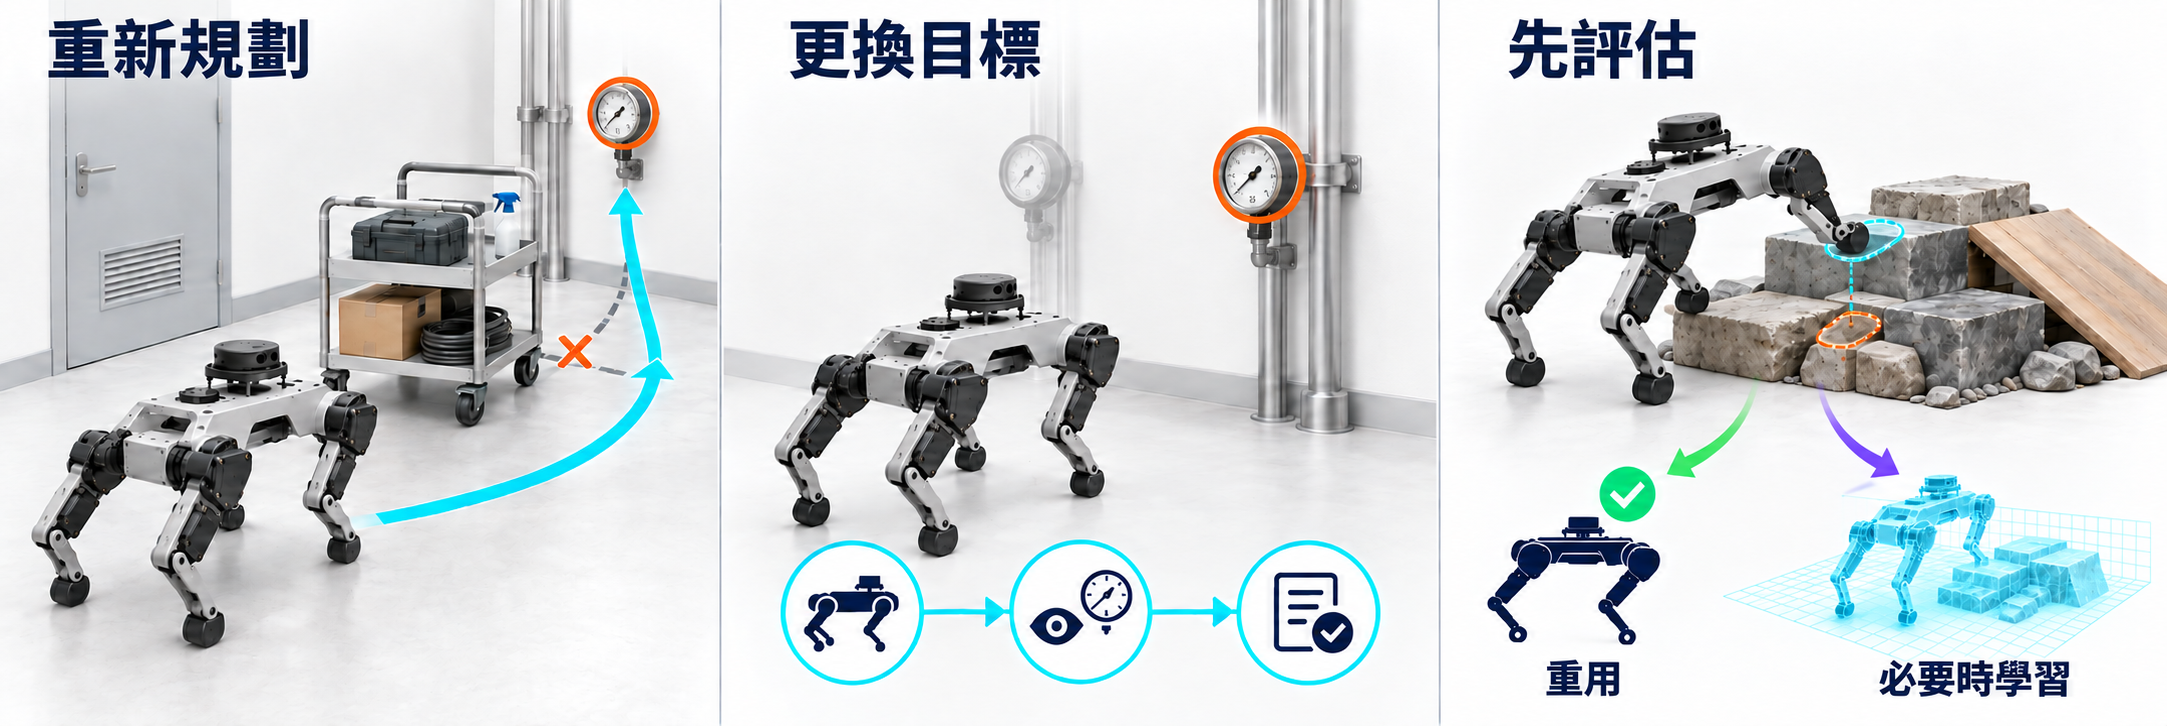
目標改變時,可以保留原有的動作順序。如果任務需要另一種順序,就要重新組合技能。陌生條件需要評估,但並不代表一定要重新訓練。
Open X-Embodiment 與 Physical Intelligence 的 π0.5 等研究,正在探索如何從更廣泛的經驗中學習,並泛化到新的環境。這些工作為我們提供方向參考,但不能證明任何機器人都能完成任意新任務。
我們希望研究的問題
第一個具體問題是:量測哪些物理量,能讓在模擬中學到的運動在硬體上更可靠?
待行走平台準備就緒後,我們構想進行一項對比實驗:一種策略在初始模擬器中訓練,另一種則在根據關節反應與地面接觸量測資料校準後的模擬器中訓練。讓移動任務、策略設計與訓練資源投入維持可比,有助於單獨檢視校準的影響。
接著,兩種策略將面對同一組未用於訓練的實機條件。我們會比較任務穩定完成情況、運動追蹤誤差與人工介入情況,以檢驗模型改進能否在校準條件之外,也提高轉移效果。
更廣泛的問題仍包括:不確定的觀測應如何影響計畫、既有技能何時能用於新任務,以及機器人何時應該請求協助。這些問題把受控實驗與可靠完成整項任務的最終目標連結起來。
專案仍處於早期原型階段:數位腿部設計與電子零組件選型已經準備好;實機行走、整合導航,以及針對這台機器人的已訓練策略,都仍待驗證。
專案參考:TNY-360 與 Orion 為我們的研究方向提供了參考。腿部設計根據 TheRobotStudio 的 SO101 幾何模型 改造,依其 Apache 2.0 授權條款 修改了底座與腿部下段。