 FreeRTOS
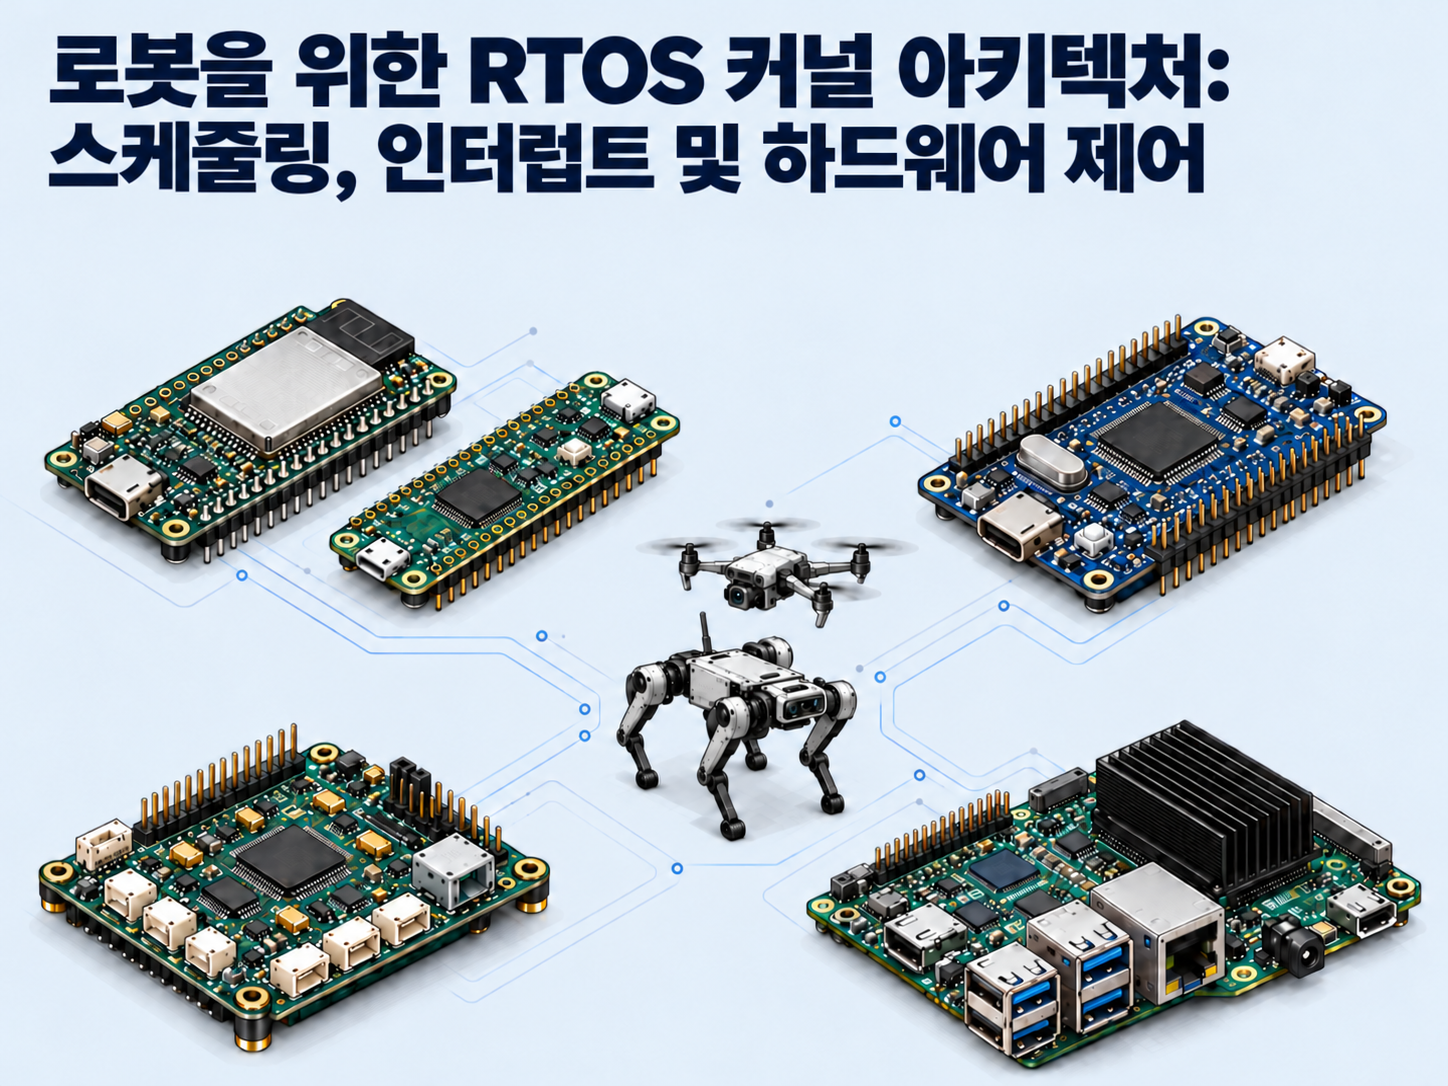
ESP32 / STM32 / Pico / Pico 2 ↗
Zephyr
ESP32 / STM32 / nRF52840 ↗
NuttX / ChibiOS
Pixhawk 4
PX4 + NuttX / ArduPilot + ChibiOS ↗
Linux / PREEMPT_RT
Raspberry Pi 5 / Jetson Orin / Intel / AMD ↗
이 글의 내용
이 글의 내용
로봇에는 올바른 명령이 아직 보정에 도움이 되는 시점에 도착해야 합니다. **실시간 운영체제(RTOS)**는 센싱부터 구동까지의 작업을 조율합니다. 센서 입력에서 하드웨어 출력까지, 하나의 관절 보정이 RTOS 구조를 통과하는 과정을 따라가 보겠습니다.
1. 프로세서는 빠른데 로봇의 반응이 늦는 이유
사족보행 로봇이 불규칙한 단차를 감지하고 올바른 보정값을 계산합니다
사족보행 로봇이 깨진 포장석을 밟습니다. 엔코더는 관절 각도의 변화를 보고하고, 관성 측정 장치(IMU)는 몸체가 회전하는 것을 감지합니다. 컨트롤러가 보정값을 계산하지만, 명령이 관절에 전달되는 동안에도 로봇은 계속 움직입니다.
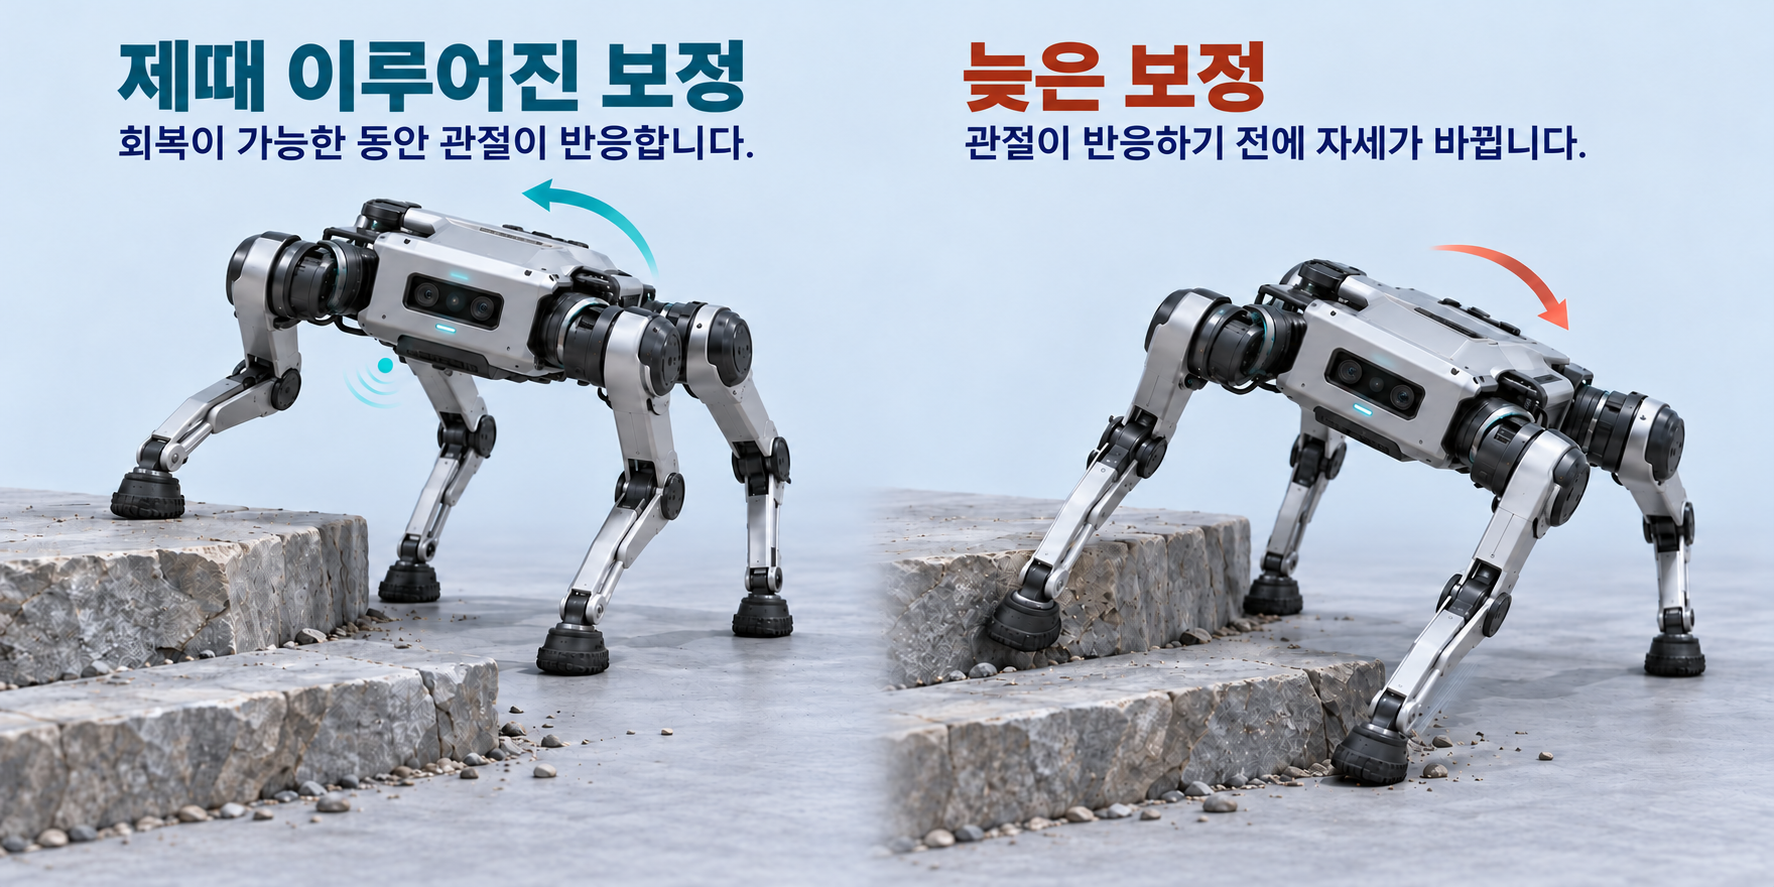
계산이 정확하다는 것만으로는 충분하지 않습니다. 이전 자세를 기준으로 만든 명령이 도착할 때는 이미 자세가 달라졌을 수 있습니다.
보정 명령이 필요한 시점보다 늦게 관절에 도착합니다
이 예시에서는 액추에이터 명령을 센서 샘플 시점으로부터 1 ms 이내에 적용해야 한다고 가정하겠습니다. 계산을 0.2 ms 만에 끝내더라도 전체 응답이 제한 시간 안에 들어온다는 보장은 없습니다.
- 주기
- 예정된 업데이트 사이의 시간
- 마감 시한
- 완료가 허용되는 가장 늦은 시점
- 응답 시간
- 샘플 취득부터 명령 적용까지
- 지터
- 업데이트마다 달라지는 시간 편차
평균 응답 시간이 짧아도 간헐적으로 갱신이 늦어질 수 있습니다. 실시간 제어에는 전체 경로에서 충분히 제한되고 일관된 타이밍이 필요합니다. ROS 2 실시간 배경 설명 에서 이 차이를 자세히 다룹니다.
2. 컨트롤러가 각 단계를 조율하는 방법
CPU, 메모리, 드라이버가 센서 측정값을 관절 명령으로 바꾸는 과정
마이크로컨트롤러 기반 임베디드 시스템에서 CPU는 측정값을 읽고 목표값을 계산한 뒤 드라이버를 호출합니다. 드라이버가 주변장치를 설정하면 주변장치가 액추에이터 인터페이스로 신호를 전달합니다.
로봇 하드웨어 가이드 에서는 모터, 전달 장치, 센서, 관절 부하가 액추에이터 인터페이스를 어떻게 결정하는지 설명합니다.
- 센서IMU / 엔코더샘플 취득
- CPU + RAM제어 태스크목표값 계산
- 드라이버레지스터 쓰기전송 설정
- 주변장치타이머 / CAN신호 전달
- 관절 드라이브전력단명령 적용
PWM 드라이버가 타이머의 비교 레지스터에 값을 쓰면, 타이머는 CPU가 매번 신호 에지를 전환하지 않아도 펄스를 생성합니다. 버스 드라이버는 전송을 준비하며, DMA의 도움을 받기도 합니다. 레지스터 기록, 전송 완료, 명령 적용은 서로 다른 시점입니다.
명령어 수준에서 메모리 매핑 레지스터는 주변장치 버스가 해석하는 주소입니다. CPU의 저장 명령은 일반 RAM 변수 대신 하드웨어 상태를 바꿉니다. 타이머는 다음 갱신 시점에야 새로운 비교값을 반영할 수 있습니다. ST의 타이머 가이드 는 이 프리로드 메커니즘을 설명합니다. CAN 전송 역시 버스 접근을 기다려야 합니다. 그다음 드라이브가 명령을 적용할 시점을 결정합니다. 이러한 대기는 태스크 선택 이후에도 남아 있습니다.
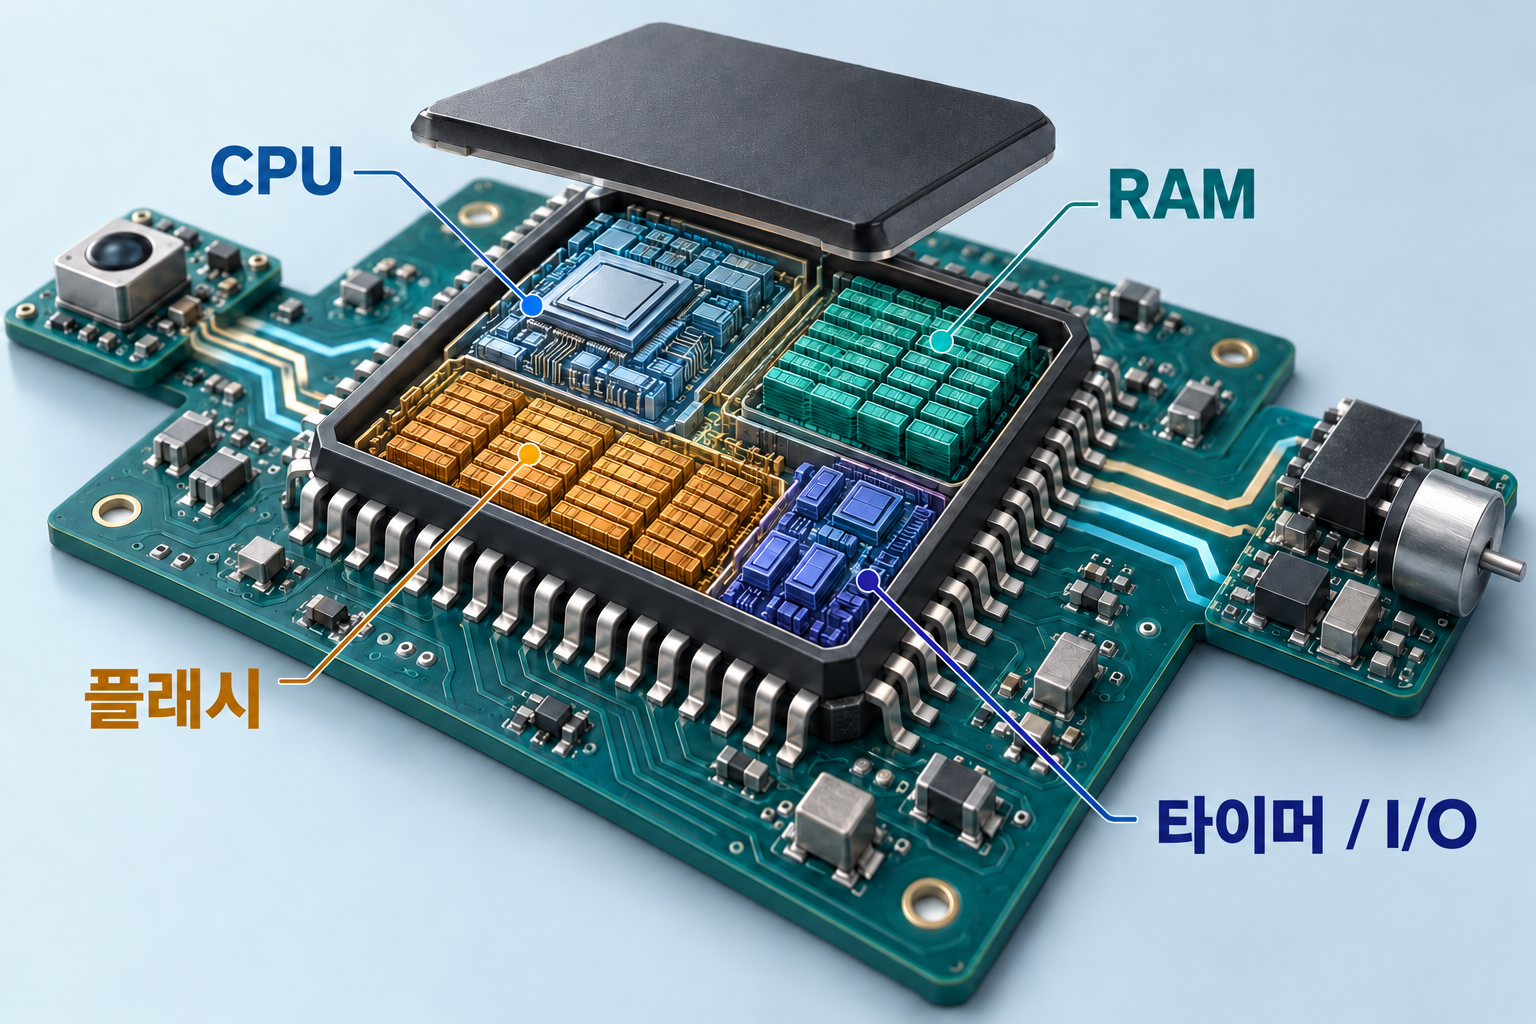
- 01CPU 저장 명령
- 02타이머 비교 레지스터
- 03PWM 파형
- 04모터 드라이브
제어 핀은 신호를 전달합니다. 동작에 필요한 전력은 모터 드라이브가 공급하며, 드라이브가 더 빠른 자체 전류 루프를 실행할 수도 있습니다. 피지컬 AI를 구성하는 전자장치 에서는 주변 회로와 전력 경로를 살펴봅니다.
xTaskCreate()설정된 할당자가 힙에서 스택과 TCB 를 확보합니다.
xTaskCreateStatic()애플리케이션이 스택 배열과 TCB 저장 공간을 제공합니다.
- 스택
- 지역 변수, 함수 호출, 저장된 CPU 컨텍스트
- TCB · 태스크 제어 블록
- 우선순위, 리스트 연결, 저장된 스택 컨텍스트의 포인터
각 태스크는 실행 스택과 TCB를 위한 RAM이 필요합니다. 스택은 함수 호출 상태와 저장된 레지스터를 보관하고, TCB는 해당 컨텍스트의 위치를 커널에 알려 줍니다. 태스크가 대기(Blocked) 상태여도 스택 영역은 계속 확보되어 있습니다.
xTaskCreate()xTaskCreateStatic()업스트림 FreeRTOS의 xTaskCreate()는 설정된 할당자를 통해 스택과 TCB를 확보합니다. xTaskCreateStatic()은 애플리케이션이 제공한 저장 공간을 사용합니다. 두 방식 모두 RAM을 소비하며, 정적 생성은 해당 객체의 힙 할당을 없애는 것입니다. 업스트림 FreeRTOS는 스택 깊이를 StackType_t 요소 수로 지정하지만 ESP-IDF의 태스크 생성 API는 바이트를 사용합니다. 스택 크기를 그대로 가져오기 전에 태스크 API
와 IDF 포트의 차이
를 확인해야 합니다.
메모리 사용 계획을 보면 플랫폼이 나뉘는 이유를 이해할 수 있습니다. 작은 FreeRTOS 커널과 Linux 시스템은 서로 다른 서비스를 포함합니다. 칩을 선택하기 전에 각 수치에 무엇이 포함되는지 비교해야 합니다.
| 집계 대상 | FreeRTOS 참고 수치 | 임베디드 Linux 참고 수치 |
|---|---|---|
| 커널 코드 / 저장 공간 | 약 9~18 KBRichard Barry가 2022년에 제시한 실용적인 커널 구성의 수치입니다.FreeRTOS 크기 논의 ↗ | 약 2~4 MB2017년 Bootlin 발표에서 제시한 임베디드 커널 저장 공간의 기준입니다.Bootlin 커널 크기 자료 ↗ |
| 공개 사례의 RAM 사용량 | 21,944바이트 약 22 KBSTM32F3 기반 Crane 애플리케이션의 한 사례로, 스택·버퍼·객체·애플리케이션 데이터를 포함합니다.2026년 연구 · 표 11 ↗ | 32 MB 이상좀 더 현실적인 소형 Linux 시스템에 대한 2022년 지침입니다. 매우 기본적인 시스템은 더 적은 메모리로도 동작할 수 있습니다.Bootlin RAM 지침 ↗ |
메모리 선택: MCU 펌웨어, Linux, 할당 방식
MCU 기반 임베디드 시스템에서는 온칩 SRAM에 태스크 스택, 샘플, 버퍼를 저장하고, 펌웨어는 대개 플래시에 보관합니다. 외부 DRAM과 MMU를 갖춘 애플리케이션 프로세서는 Linux 프로세스, 가상 메모리, 더 큰 드라이버 구성을 지원할 수 있습니다. 어느 쪽이든 메모리 용량만으로 타이밍이 보장되지는 않습니다.
핵심 작업 메모리는 루프를 시작하기 전에 준비합니다. FreeRTOS는 정적·동적 객체 할당 을 지원하지만, 스택·큐·버퍼의 크기는 개발자가 정해야 합니다. 힙 관리 가이드 에서 각 저장 방식을 설명합니다.
RTOS 커널 내부: 태스크, 인터럽트, 스케줄링의 협력
RTOS는 운영체제의 한 범주입니다. FreeRTOS와 Zephyr는 스케줄링과 동기화를 제공하는 구현체입니다. 개발자는 이 메커니즘을 설정하고 애플리케이션 태스크를 구현합니다.
FreeRTOS 태스크 스케줄링을 살펴보기 위해 여기서는 선점형 단일 코어 구성을 사용합니다. 제어 태스크가 새 데이터를 기다리는 동안 센싱과 텔레메트리는 각각의 실행 컨텍스트를 갖습니다.
커널은 **태스크 제어 블록(TCB)**에 태스크 상태를 저장합니다. pxTopOfStack은 저장된 컨텍스트의 위치를 가리키고, uxPriority는 우선순위를 정하며, 목록 항목은 태스크를 상태·이벤트 목록에 연결합니다. RTOS 컨텍스트 전환은 저장된 실행 위치에서 태스크를 재개합니다.
우선순위 3 + 준비 / 대기 목록 링크
저장된 CPU 컨텍스트
전환이 허용되면 실행 가능한 준비(Ready) 태스크 중 우선순위가 가장 높은 태스크가 선택됩니다. 높은 우선순위 태스크가 한 번도 대기하지 않으면 낮은 우선순위 작업이 실행 기회를 잃을 수 있습니다. FreeRTOS 태스크 구현 을 참고하세요.
단일 코어 모델의 준비 목록은 우선순위별로 관리됩니다. 큐를 기다리며 대기 상태가 된 태스크는 준비 집합에서 빠져 대기자로 등록됩니다. 유한한 타임아웃에는 지연 목록 관리도 필요합니다. 이벤트나 타임아웃이 발생하면 다시 실행 후보가 됩니다. 커널은 목록 갱신을 보호하여 인터럽트가 수정 중인 스케줄링 구조를 보지 않도록 합니다. 설정에 따라 포트에 최적화된 비트맵으로 우선순위를 찾기도 하지만, 모든 칩에서 하나의 동일한 알고리즘을 사용하는 것은 아닙니다.
이제 센서에서 데이터 준비 인터럽트가 발생한다고 가정하겠습니다. 아래에서 실행이 인계되는 전체 과정을 살펴봅니다. 준비(Ready) 상태가 곧 실행(Running) 상태는 아닙니다.
- 1대기
- 제어
- 대기
- CPU
- 텔레메트리 태스크
제어 태스크는 새 샘플을 기다립니다. 그동안 우선순위가 낮은 텔레메트리가 CPU를 사용할 수 있습니다.
- 2인터럽트
- 제어
- 대기
- CPU
- 센서 ISR
데이터 준비 인터럽트가 태스크 실행을 선점합니다. ISR은 센서 이벤트를 확인하고 인터럽트 발생 원인을 처리합니다.
- 3깨우기
- 제어
- 준비
- CPU
- 센서 ISR
ISR에서 안전하게 사용할 수 있는 커널 연산이 제어 태스크를 깨웁니다. 실행 가능한 상태가 되지만 ISR은 아직 실행 중입니다.
- 4전환
- 제어
- 준비
- CPU
- PendSV / 컨텍스트 전환
더 높은 우선순위의 예외 처리가 허용하는 시점에 포트가 기존 태스크의 컨텍스트를 저장하고 선택된 태스크를 복원합니다.
- 5실행
- 제어
- 실행
- CPU
- 제어 태스크
예외 복귀 후 제어 태스크가 재개되어 샘플을 읽고 관절 보정값을 계산할 수 있습니다.
Cortex-M4F 포트에서는 전환 요청으로 낮은 우선순위 예외인 PendSV를 보류 상태로 만들 수 있습니다. 먼저 하드웨어가 예외 프레임을 저장하고, 포트가 나머지 태스크 컨텍스트를 저장한 뒤 다른 TCB를 선택하여 해당 태스크를 복원합니다. **프로세스 스택 포인터(PSP)**는 태스크의 스택을 가리키며, 핸들러 코드는 **메인 스택 포인터(MSP)**를 사용합니다.
R0–R3 · R12 · LR · PC · xPSRR4–R11 · EXC_RETURN- 저장PendSV가 나머지 레지스터를 기존 태스크 스택에 저장합니다.
- 선택
vTaskSwitchContext()는 커널 보호 아래 다음으로 실행 가능한 태스크를 선택합니다. - 복원다음 TCB의 스택 포인터를 불러오고 포트가 저장한 레지스터를 복원합니다.
- 복귀예외 복귀 시 하드웨어 프레임이 복원되며, 저장된 PC에서 실행을 재개합니다.
- PSP
- 태스크 스택 포인터
- MSP
- 핸들러 스택 포인터
- BASEPRI
- 인터럽트 우선순위 마스킹 임계값
포트는 다음 태스크를 선택하는 동안 BASEPRI를 높여 커널 데이터에 접근할 수 있는 우선순위의 인터럽트를 마스킹합니다. 더 긴급한 인터럽트는 활성 상태로 둘 수 있지만, 해당 FreeRTOS API를 호출해서는 안 됩니다. PendSV가 보류 중이어도 실행 중인 더 높은 우선순위 핸들러를 뚫고 전환을 강제하지는 않습니다. 이는 Cortex-M4F 포트
에 대한 설명이며, ESP32의 Xtensa나 RISC-V 어셈블리에 대한 설명이 아닙니다.
선점은 틱 사이에도 반응할 수 있습니다. 시간 분할은 우선순위가 같은 준비 태스크를 틱마다 번갈아 실행합니다. 두 기능은 각각 별도의 FreeRTOS 설정 스위치 를 사용합니다.
컨텍스트 전환 내부: 레지스터, 스택, 다른 스케줄러
Cortex-M 예외는 CPU 컨텍스트의 일부를 저장합니다. 포트가 나머지 태스크 컨텍스트와 스택 포인터를 저장하고, 예외에서 복귀하면 선택된 태스크의 명령 실행이 재개됩니다. Memfault의 설명 은 PSP/MSP, 예외 프레임, BASEPRI 마스킹, 부동소수점 컨텍스트를 다룹니다.
ISR은 적절한 ISR 안전 커널 연산을 사용하고, API나 포트가 요구할 때 전환을 요청해야 합니다. 다음 틱을 기다릴 필요는 없습니다. 해당 Cortex-M 포트에서는 API 호출이 허용되는 임계값보다 높은 우선순위의 인터럽트가 FreeRTOS API를 호출하면 안 됩니다.
FreeRTOS 태스크 관리 예시 는 단일 코어 모델을 더 자세히 설명합니다. Zephyr 스케줄링 은 여러 준비 큐 구현과 협력형·선점형 스레드 클래스를 제공합니다.
큐, 세마포어, 뮤텍스가 태스크와 공유 자원을 조율하는 방법
여기서 RTOS 태스크 동기화의 역할은 두 가지입니다. 센서 샘플을 전달하고, 대기 중인 제어 태스크를 깨우는 것입니다. 경계를 넘어 전달해야 하는 정보에 맞춰 커널 객체를 선택합니다.
| 커널 객체 | 담는 정보 | 로봇에서의 용도 |
|---|---|---|
| 큐 | 데이터버퍼에 저장된 메시지 | 타임스탬프가 있는 센서 샘플 |
| 이진 세마포어 | 0 또는 1사용 가능한 허가 하나 | 전송 완료 신호 반복 이벤트가 하나로 합쳐질 수 있음 |
| 계수 세마포어 | 0 … N여러 개의 허가 | 사용 가능한 버퍼 슬롯 수 계산 |
| 뮤텍스 | 소유권자원에 대한 배타적 접근 | 태스크 수준의 버스 접근 보호 기본 우선순위 상속 |
샘플이 준비되면 이를 기다리던 수신 태스크가 대기(Blocked) → 준비(Ready) 상태로 바뀔 수 있습니다. CPU를 얻는 것은 그다음입니다. 세마포어는 샘플 자체가 아니라 사용 가능 상태를 전달하며, 뮤텍스는 여기에 소유권과 기본 우선순위 상속을 더합니다.
FreeRTOS의 큐는 원형 데이터 버퍼, 항목 개수, 송수신을 기다리는 태스크 목록으로 구성됩니다. 전송 시 설정된 항목 크기만큼 바이트를 복사하며, 대기 중인 수신 태스크를 깨울 수 있습니다. 세마포어는 크기가 0인 데이터 항목으로 큐의 메커니즘을 재사용합니다. 중요한 것은 데이터 버퍼가 아니라 개수와 대기 목록입니다. 뮤텍스는 소유자도 추적하므로 커널이 그 태스크의 우선순위를 일시적으로 높일 수 있습니다. 큐 구현 에서 이 관계를 확인할 수 있습니다.
큐 데이터의 최신성, 이벤트 개수, 소유권
이진 세마포어는 허가를 최대 하나만 보관하므로 반복 이벤트가 하나로 합쳐질 수 있습니다. 계수 세마포어는 사용 가능한 여러 허가의 수를 추적합니다. FreeRTOS는 태스크 알림도 제공하며, 이벤트의 의미가 맞는 경우 단일 수신 태스크에 유용합니다.
제어 큐가 가득 찼을 때 데이터를 거부할지, 오래된 데이터를 덮어쓸지, 오버런을 보고할지 결정해야 합니다. 오래 쌓인 데이터보다 최신의 완전한 샘플 하나가 더 유용할 수 있습니다. 포인터를 전달하는 메시지도 버퍼 소유권을 명확히 해야 합니다. 큐 예시 와 큐·세마포어 공통 구현 을 참고하세요.
3. 중요한 보정도 지연될 수 있는 이유
준비된 제어 태스크가 곧바로 실행되지 못하는 이유
높은 우선순위 태스크도 실행 후보이면서 CPU를 넘겨받지 못할 수 있습니다. 의존하는 조건을 기다리고 있을 수도 있습니다. 태스크 우선순위를 높이는 것만으로 어느 쪽 대기도 자동으로 사라지지 않습니다.
CPU가 보호 구간이나 인터럽트 핸들러를 실행 중이므로 태스크 실행 전환을 기다려야 합니다.
필요한 샘플이나 자원이 준비되지 않았거나 타임아웃 조건이 충족되지 않았습니다.
임계 구역, 인터럽트 마스킹, 스케줄러 일시 중지, ISR 실행은 FreeRTOS에서도 태스크 실행 전환을 늦출 수 있습니다. 보호된 작업이 특별한 ‘최상위 태스크 우선순위’를 갖는 것은 아닙니다. 전환 가능한 시점을 일시적으로 제한하는 것입니다.
| 메커니즘 | CPU 또는 커널의 동작 | 제어가 기다리는 대상 |
|---|---|---|
| 비 RT Linux 스핀록 | spin_lock() 은 로컬 태스크 선점을 막습니다. IRQ는 활성 상태로 유지될 수 있습니다. | 보호 구간 종료 후 재스케줄링이 허용될 때까지. |
| 인터럽트 마스킹 | 마스킹된 인터럽트 소스는 아직 핸들러를 실행할 수 없습니다. | 마스킹 해제, 이벤트 처리, 이후 실행 전환까지. |
| ISR 실행 | 핸들러 컨텍스트가 일반적인 태스크 선택과 별개로 CPU를 점유합니다. | 예외 복귀 또는 컨텍스트 전환이 허용될 때까지. |
| 스케줄러 일시 중지 | vTaskSuspendAll() 는 태스크 전환을 미루지만 그 자체로 인터럽트를 마스킹하지는 않습니다. | 스케줄러 재개와 미뤄진 상태 관리 작업 완료까지. |
| 뮤텍스 의존성 | 다른 태스크가 소유한 자원을 기다리며 태스크가 대기 상태가 됩니다. | 소유자가 작업을 진행하고 해제할 때까지. 우선순위 상속은 다른 태스크의 간섭을 줄일 수 있습니다. |
PREEMPT_RT를 사용하지 않는 Linux에서 드라이버가 spinlock_t를 보유하고 있다고 가정하겠습니다. 활성화된 인터럽트는 더 높은 우선순위의 제어 스레드를 깨우고 재스케줄링을 요청할 수 있습니다. 그러나 인터럽트에서 돌아온 CPU는 전환하기 전에 드라이버의 보호 구간을 끝내야 할 수 있습니다. 제어 스레드는 준비 상태지만, 남은 보호 작업도 전체 응답 시간 예산에 포함됩니다.
FreeRTOS의 vTaskSuspendAll()은 인터럽트 마스킹과 다릅니다. ISR은 계속 실행될 수 있지만, 스케줄러가 재개되어 미뤄 둔 작업을 처리할 때까지 태스크 전환은 연기됩니다. 반면 Cortex-M의 임계 구역은 포트별 인터럽트 마스킹을 사용합니다. 태스크 우선순위를 높여도 어느 메커니즘도 해제되지 않습니다. Linux 잠금 규칙
은 관련 스핀록과 IRQ의 차이를 설명합니다.
숫자가 클수록 높은 우선순위
- 중간 · 2로그 기록 실행
- 낮음 · 1완료 + 잠금 해제
- 높음 · 3뮤텍스 획득 + 제어
- 낮음 · 1 → 3완료 + 잠금 해제
- 높음 · 3뮤텍스 획득 + 제어
- 중간 · 2로그 기록은 나중에 실행
우선순위 상속을 지원하는 뮤텍스의 소유자는 이를 기다리는 더 높은 우선순위 태스크의 우선순위를 일시적으로 물려받습니다. 소유자가 작업을 끝내고 자원을 해제하는 데 도움이 됩니다. 다만 임계 작업 자체를 없애거나 교착 상태를 해결하지는 않으며, 전혀 응답하지 않는 장치의 대기 시간을 제한하지도 못합니다.
커널 보호, 인터럽트 우선순위, 멀티코어 잠금
PREEMPT_RT를 사용하지 않는 Linux 구성에서 일반 스핀록을 획득하면 해당 CPU의 태스크 선점이 금지됩니다. IRQ를 비활성화하는 변형은 로컬 인터럽트 마스킹도 추가합니다. Linux 잠금 규칙 에서 이 메커니즘을 구분합니다.
태스크 우선순위와 하드웨어 인터럽트 우선순위는 별개입니다. 커널을 호출할 수 있는 인터럽트는 포트별 마스킹 임계값에 따라 결정됩니다. 멀티코어 시스템에서는 로컬 보호만으로 다른 CPU가 접근할 수 있는 자원을 보호하지 못할 수 있습니다.
자원 보유 시간에 상한을 두고 잠금의 연결 관계를 분석해야 합니다. FreeRTOS 자원 관리 장 은 뮤텍스 소유권과 기본 우선순위 상속을 설명합니다.
FreeRTOS와 데스크톱 Linux의 차이, 그리고 PREEMPT_RT의 변경점
RTOS와 Linux를 비교할 때는 전체 응답 경로를 고려해야 합니다. 두 커널 모두 태스크 상태, 우선순위, 선점, 인터럽트를 관리합니다. 차이는 구성된 시스템이 경로 전반의 간섭을 어떻게 제어하느냐에 있습니다.
- TCB + 우선순위별 준비 목록
- 실행 가능한 최고 우선순위 태스크 선택
- ISR 안전 API가 태스크를 깨움
- 남는 지연: 임계 구역이 전환을 늦출 수 있음
SCHED_FIFO / SCHED_RR사용 가능- 하드 IRQ 작업이 실행 전환을 늦출 수 있음
spinlock_t은 로컬 태스크 선점을 비활성화함- 남는 지연: 보호된 경로가 전환을 늦춤
- 대부분의 IRQ 작업이 스레드에서 실행됨
spinlock_t은 RT 뮤텍스 기반 우선순위 상속을 사용함- 선점 가능한 커널 경로가 늘어남
- 남는 지연: raw 잠금과 저수준 경로는 계속 보호됨
PREEMPT_RT는 Linux의 구성이며 FreeRTOS의 기능이 아닙니다. 인터럽트 스레드화와 우선순위 상속을 지원하는 수면 가능 잠금을 통해 더 많은 커널 작업을 스케줄러의 제어 아래 둡니다.
일반적인 스레드형 IRQ 경로에서는 짧은 하드 인터럽트 초기 처리로 발생 원인을 확인하거나 마스킹한 뒤 IRQ 스레드를 깨웁니다. 이 스레드는 스케줄링 정책과 우선순위에 따라 실행 기회를 얻습니다. PREEMPT_RT는 일반 spinlock_t를 RT 뮤텍스 기반 구현으로 바꿉니다. 잠금을 기다리는 스레드는 수면 상태로 들어갈 수 있고, 우선순위 상속은 소유자의 작업 진행을 돕습니다. raw_spinlock_t, 저수준 진입 경로, 명시적으로 보호된 다른 구간은 계속 선점할 수 없습니다. RT 커널의 차이
를 참고하세요.
눈금: 0~1,500 µs · 점선: 1,000 µs 마감 시간
적절히 설정한 PC의 실시간 Linux는 로봇 제어를 수행할 수 있습니다. 일반 Ubuntu가 엄격한 마감 시간을 충족한다고 단정할 수 없듯, 검증하지 않은 FreeRTOS 시스템도 보장할 수 없습니다. 오픈 소스 라이선스 여부는 이러한 타이밍 문제와 별개입니다.
스케줄링상 실행이 허용된 뒤에도 메모리 때문에 지연이 추가될 수 있습니다. 가상 메모리에서는 페이지 할당, 쓰기 시 복사, 파일이나 스왑 읽기가 필요해 명령 실행 중 페이지 폴트가 발생할 수 있습니다. 저장 장치 접근을 수반하는 폴트는 일부입니다. 일반적인 MCU FreeRTOS 시스템은 요구 페이징 없이 상주 메모리를 사용하지만, 할당, 플래시·캐시 접근, 버스, 장치로 인한 대기는 여전히 발생할 수 있습니다.
- 예약된 RAM
- 태스크 스택과 버퍼 재사용
- 요구 페이징에 따른 페이지 폴트 단계 없음
Linux 제어 스레드는 루프를 시작하기 전에 핵심 버퍼와 스택 페이지를 준비하고, 필요한 매핑에 미리 접근해 페이지를 확보하며, 오류와 제한을 확인하면서 적절한 메모리 잠금을 사용해야 합니다. mlockall()이 이후의 할당이나 쓰기 시 복사를 무해하게 만드는 것은 아닙니다. PREEMPT_RT 자체도 페이지 폴트를 없애지 않습니다. 메모리 잠금 매뉴얼
에서 이 제약을 설명합니다.
Linux 우선순위, 페이지 폴트, PREEMPT_RT의 절충점
Linux는 일반 애플리케이션 정책과 SCHED_FIFO, SCHED_RR 같은 실시간 정책을 제공합니다. nice 값은 이러한 정책 설정을 대신하지 못합니다. 스케줄링 매뉴얼 이 인터페이스를 정의합니다.
주소를 사용할 수 있게 되기 전에 페이지 폴트 처리 작업이 추가될 수 있습니다. 핵심 메모리를 미리 할당하고 페이지에 사전 접근하며, 실패와 제한을 확인하면서 적절한 메모리 잠금을 사용해야 합니다. mlockall() 은 메모리 상주를 돕지만 CPU, 잠금, 캐시, 장치 지연을 해결하지는 않습니다.
스레드화된 작업과 달라진 잠금 방식은 일부 작업 부하에서 오버헤드를 늘리거나 처리량을 낮출 수 있습니다. 우선순위, 인터럽트 배치, 전력 관리, CPU 배치, 드라이버를 주의 깊게 설정해야 합니다. 비용은 작업 부하에 따라 달라지며 일정한 비율이 아닙니다. RT 이론 , 커널 차이 , 하드웨어 제약 을 참고하세요.
이제 보정 전체에 하나의 시간 예산을 정합니다. 센싱, 간섭, 계산, 전송, 출력 적용에 각각 상한을 두고, 계산을 중단시키는 더 높은 우선순위 작업도 포함합니다.
고정 처리 480 µs + 대기 120 µs = 총 600 µs
1,000 µs 마감 시간 충족 · 여유 400 µs
고정 처리 480 µs + 대기 800 µs = 총 1,280 µs
1,000 µs 마감 시간 초과 · 280 µs 지연
측정 + 대기/간섭 + 계산 + 전송 + 출력 적용 ≤ 마감 시간. 고정 단계의 합은 480 µs입니다. 두 예시에서는 대기 시간 예산만 달라집니다.
대기 시간이 120 µs라면 이 예시의 합계는 600 µs로, 1,000 µs 마감 시간까지 400 µs가 남습니다. 대기가 800 µs라면 고정 작업은 같아도 전체가 1,280 µs가 되어 280 µs 늦게 도착합니다. 이는 설명을 위한 값이며 보드에서 측정한 수치가 아닙니다.
- 0 µs샘플 획득센서 타임스탬프
- 70 µsISR 진입GPIO / 추적 마커
- 190 µs제어 시작태스크 마커
- 390 µs계산 종료드라이버 호출 경계
- 510 µs전송 완료버스 신호 캡처
- 600 µs출력 적용드라이브 / 출력 마커
실제로 출력이 적용되는 시점까지 측정해야 합니다. 스케줄러 지연만으로 드라이브의 명령 적용 시점을 알 수 없으며, 한 번의 실행에서 관측한 최대 지연도 최악 조건의 증명이 되지는 않습니다.
하드웨어에서 경로 검증하기
센서 샘플 획득, ISR 진입, 태스크 시작, 계산 종료, 전송 완료, 출력 적용 시점에 타임스탬프를 남깁니다. GPIO 마커와 로직 분석기가 도움이 될 수 있습니다. 마커가 같은 이벤트를 추적하며 클록 도메인도 명확해야 합니다. 경쟁하는 통신, 저장 장치 작업, 인터럽트에도 부하를 가해야 합니다.
Canonical의 cyclictest 가이드 는 경로 중 스케줄링과 관련된 부분을 측정합니다. Linux 실시간 애플리케이션 모니터 는 지원 커널에서 폴트와 대기 패턴을 진단하는 데 도움이 됩니다. ROS 2 실시간 배경 설명 , PREEMPT_RT 내부 구조 , Zephyr 뮤텍스 문서 에서 더 자세한 내용을 확인할 수 있습니다.
4. 로컬 제어에서 완성된 로봇으로
제어 펌웨어를 만들고 사용자 정의 SDK로 공개하기
FreeRTOS와 Linux의 선택은 센싱과 동작을 수행할 하드웨어에서 시작합니다. RAM, CPU 아키텍처, 주변장치 드라이버, 타이밍 요구 사항이 해당 작업을 수행할 소프트웨어를 결정합니다. 아래는 지원 대상별 선택 예시로, 플랫폼마다 두 가지 옵션을 제시합니다.
| 칩 / 보드 | 두 가지 소프트웨어 선택지 | 적합한 이유 | 로봇 내 역할과 하드웨어 근거 |
|---|---|---|---|
| ESP32 / S3 / C3무선 MCU 수백 KB의 온칩 SRAM. 용량은 칩에 따라 다릅니다. | 작은 태스크 커널은 스택과 무선 버퍼를 위한 공간을 남깁니다. IDF는 칩 드라이버와 서비스를 통합합니다. | 무선 센싱 / 로봇 I/O. 무선으로 데이터를 교환하고 타이머와 GPIO로 로컬 신호를 처리합니다. | |
| RP2040 / RP2350Pico / Pico 2 MCU 264 KB / 520 KB SRAM ↗ | 베어메탈 코드는 커널 태스크 오버헤드를 피합니다. FreeRTOS는 스케줄링과 동기화 를 SRAM 내에서 제공합니다. | 엔코더 / 펄스 생성. PIO, 타이머, DMA는 신호 에지마다 CPU가 처리하지 않아도 신호를 수집하거나 생성합니다. | |
| STM32 F4 / F7 / H7Cortex-M MCU 제품군 플래시와 SRAM 용량은 부품에 따라 다릅니다. | 구성 가능한 MCU 커널은 완전한 Linux 프로세스 환경 없이 제어, 측정, 통신 을 구성합니다. | 모터 / 관절 컨트롤러. ADC, 타이머, DMA, 버스가 피드백 샘플링과 액추에이터 명령을 연결합니다. | |
| Nordic nRF52840무선 Cortex-M4 MCU 256 KB RAM · 1 MB 플래시 ↗ | Zephyr는 무선 서비스를 통합합니다. 독립 드라이버는 더 단순한 주변장치 펌웨어에 적합합니다. 두 방식 모두 RAM 사용 계획이 필요합니다. | 배터리 구동 센서. 무선과 절전 모드는 간헐적 측정에 적합합니다. 베어메탈 nrfx만으로는 Bluetooth 스택이 되지 않습니다. | |
| STM32F765Pixhawk 4 비행 컨트롤러 512 KB RAM · 2 MB 플래시 ↗ | 보드별 비행 펌웨어는 RTOS와 센서 드라이버, 태스크 스택, 버퍼를 결합합니다. | 드론 자세 안정화. IMU 샘플링, 추정, 제어를 통해 제때 ESC 명령을 생성합니다. | |
| BCM2712Raspberry Pi 5 애플리케이션 SoC GB 단위 외부 DRAM ↗ | MMU와 외부 DRAM은 프로세스, 가상 메모리, 파일 시스템, Linux 드라이버를 지원합니다. | ROS 2 / 카메라 / 게이트웨이. 멀티코어 연산과 카메라·네트워크 I/O가 호스트의 동시 작업을 지원합니다. | |
| NVIDIA OrinJetson CPU / GPU 모듈 GB 단위 DRAM. 용량은 모듈에 따라 다릅니다. | Linux는 GPU와 장치 서비스를 제공합니다. 지원되는 릴리스에서 RT 커널은 CPU 실행 전환과 인터럽트 처리 를 변경합니다. | 비전 / AI 추론. GPU가 프레임과 텐서를 처리합니다. CPU 실시간 튜닝으로 모든 GPU 연산의 시간 상한을 정할 수는 없습니다. | |
| Intel / AMDPC 애플리케이션 프로세서 외부 DRAM + MMU. | 폭넓은 프로세스·드라이버 플랫폼이 대규모 애플리케이션을 처리하며, RT 설정은 커널로 인한 대기 시간을 줄입니다. | 개발 / 계획 / 검증된 제어. CPU 성능은 복잡한 작업을 지원합니다. 직접 제어에는 여전히 적합한 I/O와 타이밍 검증이 필요합니다. |
센싱과 피드백 제어에는 명확한 깨우기 조건, 우선순위, 실행 시간 제한, 충분한 스택을 지정합니다. 파싱, 네트워크 통신, 로그, 저장 장치 작업이 핵심 루프에 필요한 자원을 계속 점유하지 않도록 해야 합니다.
커널은 스케줄링과 동기화를 제공합니다. 펌웨어는 제어 동작과 드라이버를 구현하고, 사용자 정의 SDK는 명령과 측정 상태를 외부에 공개합니다.
앞서 본 인터럽트 인계 과정을 작은 FreeRTOS 패턴으로 표현하면 다음과 같습니다. 항목 하나를 담는 큐가 최신의 완전한 샘플을 유지합니다. 인터럽트를 활성화하기 전에 큐와 태스크를 만들고, 처리 시간에 상한이 있는 하드웨어 경로로 샘플을 획득합니다.
void sample_isr(void) {
  BaseType_t wake = pdFALSE;
  Sample s = read_ready_sample();
  xQueueOverwriteFromISR(
    sample_q, &s, &wake);
  portYIELD_FROM_ISR(wake);
}
완료된 샘플 하나를 복사하고, 높은 우선순위 태스크가 깨어나면 전환을 요청합니다.
void control_task(void *arg) {
  Sample s;
  for (;;) {
    xQueueReceive(sample_q, &s,
                  portMAX_DELAY);
    Target t = target_snapshot();
    Command u =
      control_step(s, t);
    actuator_write(u);
  }
}
샘플 사이에는 대기합니다. 일관된 목표값과 시간 상한이 있는 출력 경로를 사용합니다.
ISR은 완료된 샘플을 복사하고 필요하면 전환을 요청합니다. 태스크는 CPU를 소비하지 않고 기다리다가 일관된 목표 스냅샷을 읽고, 다음 출력을 계산한 뒤 드라이버를 호출합니다. 여러 필드로 구성된 목표값은 메시지 전달이나 시간이 제한된 태스크 수준 잠금을 사용해 일관된 한 버전으로 복사해야 합니다. 느린 I/O가 진행되는 동안 그 잠금을 유지해서는 안 됩니다.
주기 루프에서는 상대 지연을 반복하여 작업 시간이 누적되게 하기보다 적절한 타이머나 xTaskDelayUntil()을 사용합니다. 틱 해상도는 주기에 맞아야 하며, 틱보다 짧은 시간 요구에는 적절한 하드웨어 타이밍 소스가 필요합니다.
제공되는 커널 설정에서 configUSE_PREEMPTION, 우선순위 범위, 할당 옵션, 스택 크기를 지정한 뒤 태스크와 동기화를 구현합니다. 보통 준비 목록의 선택 로직을 직접 작성하는 대신 스케줄러를 설정하고 이식합니다. 지원되는 듀얼 코어 ESP-IDF 구성에서 ESP32의 FreeRTOS를 실행하면 스케줄러는 코어 선호도도 고려합니다. 태스크를 코어에 고정해도 공유 메모리나 버스가 격리되지 않으며, 로컬 인터럽트 마스크가 다른 코어를 멈추게 하지도 않습니다. 공유 데이터에는 해당 타깃에서 지원하는 코어 간 동기화가 필요합니다.
- 관절
- joint_3
- position_rad
- 0.15
- sequence
- 42
- 유효 기간
- 정의된 유효 시간 범위
- 측정 위치
- 라디안
- 샘플 타임스탬프
- 명시된 클록 도메인
- 적용된 시퀀스 번호
- 어떤 명령을 사용했는지
- 상태
- 최신 / 오래됨 / 오류
단위, 허용 범위, 타임스탬프, 시퀀스 번호, 수신 확인, 데이터 최신성, 타임아웃 동작을 정의합니다. 명령을 받았다는 사실이 물리적 실행을 증명하지는 않습니다.
통신 경계에서는 필드 폭, 바이트 순서, 프레이밍, 필요한 무결성 검사를 포함해 직렬화를 명확히 정의합니다. 호스트에서 패딩이 달라질 수 있는 C 구조체를 그대로 전송하지 않아야 합니다. 컨트롤러는 패킷을 검증하고 완전한 목표값을 게시하며, 실제 적용한 시퀀스를 보고합니다. 타임아웃 시에는 기구에 맞는 유지, 점진적 감속, 오류 대응 중 미리 정의한 동작을 선택할 수 있습니다. SDK는 수신 사실을 동작 성공으로 표현하지 말고 해당 상태를 공개해야 합니다.
맞춤형 로봇에서는 센싱·액추에이터 통합과 함께 이러한 인터페이스의 범위를 정합니다. VoicePing의 맞춤형 로봇 개발 은 수행할 작업과 운영 환경에서 시작합니다.
ESP-IDF, 업스트림 FreeRTOS, 멀티코어 선택
ESP-IDF는 자체 FreeRTOS 구현, 드라이버, 시작 경로를 통합합니다. 지원되는 멀티코어 타깃에서는 코어 선호도와 공유 자원도 고려해야 합니다. 업스트림 FreeRTOS도 SMP를 지원하므로 멀티코어 스케줄링 전체를 직접 구현할 필요는 없습니다.
타깃과 릴리스에 맞는 IDF 문서 를 따라야 합니다. 코어 고정으로 일부 경쟁은 줄일 수 있지만 공유 버스, 메모리, 인터럽트의 영향까지 격리할 수는 없습니다. 클록 동기화와 타임스탬프가 샘플 획득 시각인지 전송 시각인지를 정의한 뒤 구성된 시스템을 검증합니다.
커널이 제품 플랫폼이 되는 과정. 맞춤화는 커널 포트, 애플리케이션 펌웨어, 외부 SDK 경계에서 각각 이루어질 수 있습니다. 독자적인 컨트롤러를 만들기 위해 스케줄러를 다시 작성할 필요는 없습니다.
FreeRTOS↓타깃 포트 + SMP 통합 + 하드웨어 드라이버↓애플리케이션 태스크 + 네트워크 / 주변장치 서비스개발자가 맞춤 설정하는 부분태스크 우선순위, 선호도, 버퍼, 동기화, 애플리케이션 동작.
FreeRTOS 태스크↓센서 준비 → 추정기 → 제어기 → 모터 출력↓설정값, 매개변수, 로그 기록 + 보드 지원개발자가 맞춤 설정하는 부분제어 알고리즘과 드라이버, 플랫폼 설정, 애플리케이션 모듈.
rt/lowcmd → 로봇qdqkpkdtau⇅rt/lowstate → 애플리케이션개발자가 맞춤 설정하는 부분호스트 제어 로직에 활용하는 정보는 모터 목표값과 측정 상태입니다. 이 SDK는 관절 컨트롤러의 OS를 밝히지 않습니다.
Espressif는 하드웨어에 맞춘 FreeRTOS 구현과 통합을 문서화합니다. Bitcraze의 Crazyflie는 또 다른 일반적인 방식을 보여 줍니다. FreeRTOS 태스크 위에 센서 → 추정기 → 제어기 → 모터 파이프라인을 추가하는 방식입니다. 안정화 문서 와 펌웨어 소스 에서 이 애플리케이션 계층을 확인할 수 있습니다.
Unitree는 공개 인터페이스 계층의 예시입니다. SDK2 Go2 예제 는 저수준 모터 명령을 게시하고 상태를 구독합니다. Python SDK 문서에는 Cyclone DDS가 명시 되어 있습니다. 이는 확장 가능한 로봇 인터페이스를 보여 주지만, 비공개 관절 컨트롤러가 FreeRTOS를 사용한다는 근거는 아닙니다. 문서로 확인되는 SDK 동작과 내부 펌웨어에 대한 추정은 구분해야 합니다.
사족보행 로봇과 드론에서 로컬 RTOS 제어를 ROS 2와 연결하기
이 컨트롤러를 로봇 전체에 배치해 보겠습니다. 호스트가 동작을 계획하는 동안 로컬 컨트롤러는 피드백 루프를 닫고, 관절 드라이브는 전류를 조절할 수 있습니다. 각 루프는 타이밍을 검증할 수 있는 곳에 배치합니다.
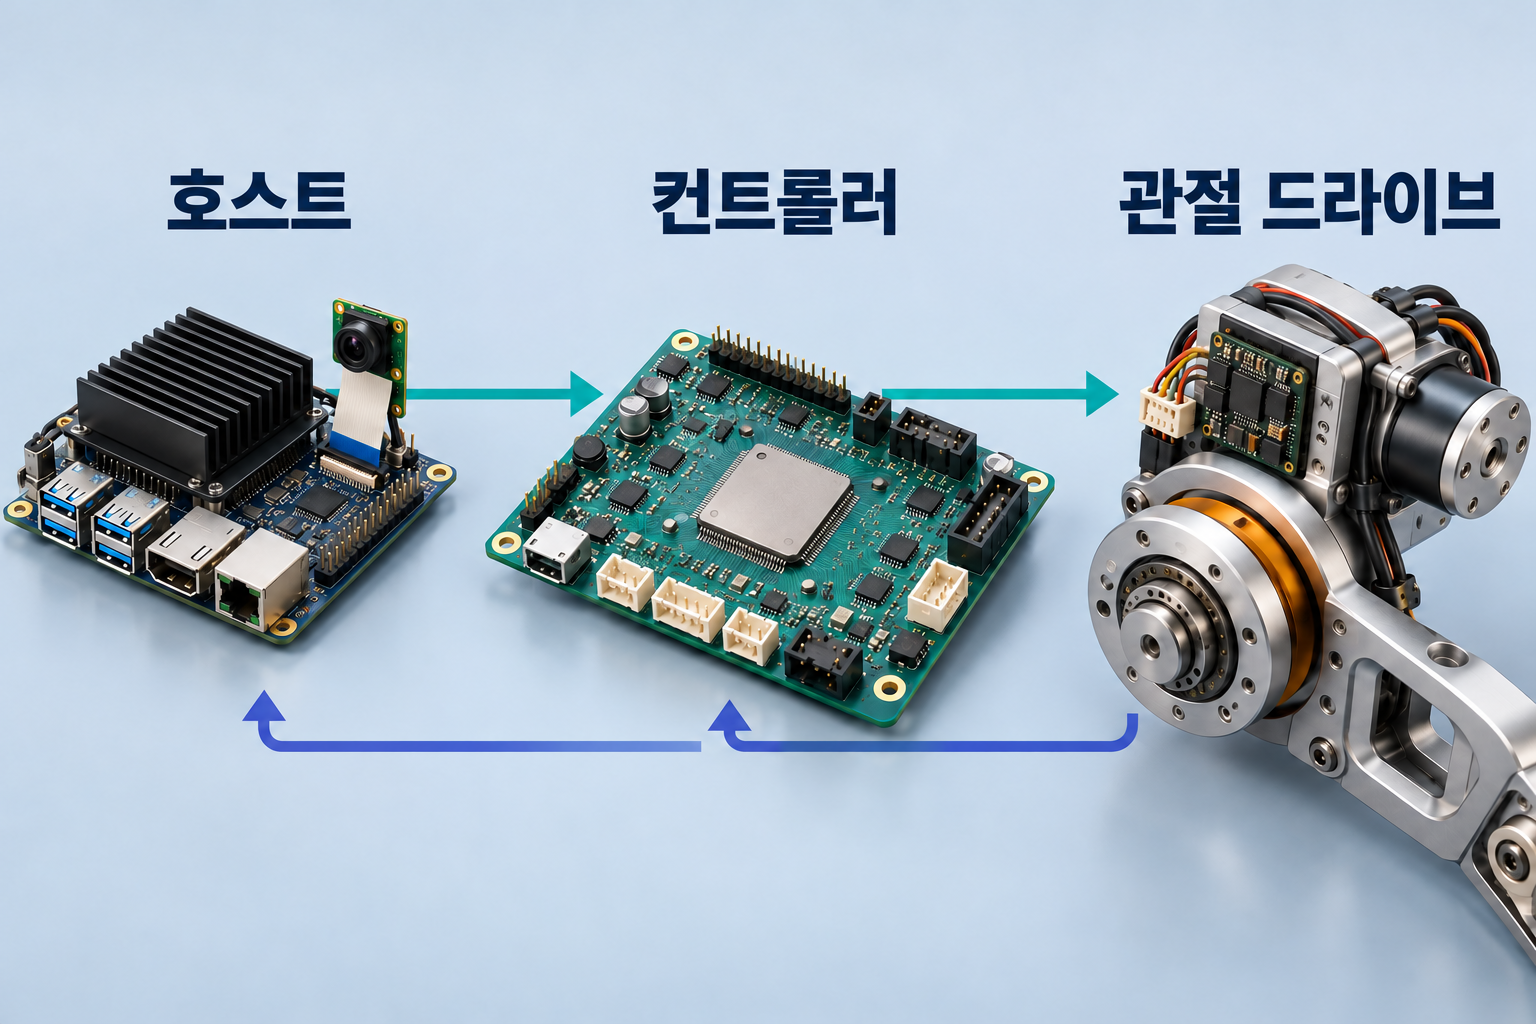
ROS 2는 미들웨어이며, RTOS는 운영체제 커널 또는 플랫폼입니다. 서로 역할이 다르며 함께 쓰이는 경우가 많습니다. 일부 루프는 적절한 Linux/PREEMPT_RT 호스트에서 실행할 수도 있습니다. ROS 2의 실시간 설계 논의 는 애플리케이션 수준의 제약을 설명합니다.
Linux는 프로세스, 카메라·네트워크 드라이버, 로봇 라이브러리, 배포 도구를 제공하므로 호스트에 유용합니다. PREEMPT_RT는 이 플랫폼을 유지하면서 커널의 응답성을 높입니다. ROS 2 콜백에도 적절한 실행기·스레드 정책, 시간 상한이 있는 작업, 준비된 메모리가 필요합니다. RT 커널이라고 모든 콜백이 자동으로 실시간성을 갖는 것은 아닙니다. FreeRTOS는 로컬 펌웨어를 위한 더 작은 실행 환경을 제공하며, 호스트의 Linux 소프트웨어 전체를 그대로 옮겨 실행하는 대체 환경은 아닙니다.
커널보다 먼저 타이밍 요구를 정해야 합니다. 비전이나 지도 작성 호스트는 처리량과 폭넓은 드라이버 구성이 중요하고, 빠른 루프는 별도 MCU가 맡을 수 있습니다. 엄격한 제어 마감 시간을 직접 책임지는 Linux 호스트에는 적절한 실시간 설정과 전체 경로 검증이 필요합니다. PC에서도 PREEMPT_RT를 실행할 수 있지만 일반적인 데스크톱 작업은 그처럼 엄격한 지연 목표를 필요로 하지 않는 경우가 많습니다.
| 비용 또는 대응 사항 | 발생 이유 | 애플리케이션 판단 |
|---|---|---|
| 처리량 감소 가능성 | IRQ 스레드 실행 전환과 우선순위 상속 잠금의 상태 관리 작업이 추가됩니다. | 실제 작업 부하로 측정해야 합니다. 모든 환경에 적용되는 오버헤드 비율은 없습니다. |
| 설정 항목 증가 | 태스크·IRQ 우선순위, 선호도, 공유 자원이 서로 영향을 줍니다. | 네트워크, 저장 장치, 시스템 관리 작업과 함께 제어를 검증합니다. |
| 낮은 우선순위 작업의 기아 위험 | 계속 실행 가능한 RT 스레드는 낮은 우선순위 작업의 실행 기회를 빼앗을 수 있습니다. | 실행과 블로킹의 상한을 관리합니다. 이 위험은 PREEMPT_RT가 없어도 존재합니다. |
| 전력과의 절충 | 일부 지연 튜닝은 깊은 유휴 상태나 주파수 변경을 제한합니다. | 전력과 발열의 균형을 맞춥니다. PREEMPT_RT를 활성화한다고 이 튜닝이 반드시 필요한 것은 아닙니다. |
| 드라이버의 전제 조건 | 일반 스핀록과 인터럽트 실행 컨텍스트가 바뀝니다. | 스핀록이 항상 선점을 비활성화한다고 가정하는 자체 드라이버를 검토합니다. |
이러한 비용은 작업 부하에 따라 달라집니다. IRQ 스레드와 우선순위 상속 잠금은 상태 관리 작업을 늘리며, CPU 배치와 드라이버의 전제 조건도 검토해야 합니다. 깊은 절전이나 주파수 변경을 막으면 응답 시간을 줄이는 대신 에너지 효율이 낮아질 수 있습니다. 이는 PREEMPT_RT의 자동 효과가 아니라 튜닝 선택입니다. Canonical의 지연 가이드 는 이러한 실무적 절충점을 설명합니다. CPU를 계속 점유하는 실시간 스레드는 비 RT 커널에서도 다른 작업의 실행 기회를 빼앗을 수 있습니다.
이러한 공존은 개발자 설문에서도 나타납니다. 아래 두 범주는 서로 다른 하드웨어 역할을 다루며, 어느 쪽도 벤치마크나 특정 MCU에 대한 권장 사항은 아닙니다.
- Linux/Raspbian45%
- FreeRTOS32%
- 베어메탈21%
- Zephyr RTOS17%
- ThreadX17%
- ROS 27%
- Contiki / Contiki-NG5%
- Huawei LiteOS5%
- Linux/Raspbian62%
- Android23%
- Windows19%
- 베어메탈12%
- ThreadX10%
- Zephyr9%
‘자원이 제한된다’는 표현은 애플리케이션에 주어진 RAM, 플래시, CPU, 전력, I/O 범위에 비추어 해석해야 합니다. ESP32급 컨트롤러와 Linux 에지 컴퓨터는 서로 다른 제약을 가질 수 있습니다. 설문에서 Linux 사용률이 높다고 데스크톱 Linux가 ESP32에 적합하다는 뜻은 아닙니다. 실제 보드의 메모리 용량, MMU 지원, 드라이버, 측정된 루프 타이밍을 확인해야 합니다.
- IMU움직임 측정
- 추정기자세 추정
- 제어기보정값 계산
- ESC모터 각 상 구동
- 모터추력 변경
같은 패턴은 드론의 자세 안정화에도 사용됩니다. 지원되는 비행 보드에서 PX4는 일반적으로 NuttX를 사용하며, ArduPilot은 여러 STM32 타깃에서 ChibiOS를 사용합니다. PX4 비행 스택 개요 , 시스템 구조 , ArduPilot 이식 가이드 를 참고하세요.
다시 사족보행 로봇으로
이제 단차에 대한 보정이 관절에 도착하기까지의 전체 과정을 따라갈 수 있습니다. 커널은 실행을 조직하지만, 제때 도착하는지는 센싱·제어·구동을 모두 포함한 경로가 결정합니다.
다음 컨트롤러를 설계할 때는 하나의 센서 이벤트를 물리적 출력까지 추적하세요. 마감 시간을 명시하고 각 대기 시간을 계산에 넣은 뒤, 실제 하드웨어에서 출력 적용 시점까지 검증해야 합니다.
이 컨트롤러를 실제 애플리케이션으로 발전시키려면 VoicePing의 로봇 엔지니어링 접근 방식 을 살펴보고 하드웨어, 제어 인터페이스, 인수 기준을 함께 정의해 보세요.